1. 車載半導体の覇権争い:なぜMobileyeの牙城は崩れ、NVIDIA一強は続かないのか
自動車の知能化が加速する中、世界の自動車メーカー(OEM)は長らく極端な「二者択一」のジレンマに縛られてきました。
一方は、単眼カメラと専用ASICをパッケージ化して納入するMobileyeのブラックボックス・モデルです。導入の手間が少なく、ADASの国際安全基準を安価に満たせる反面、自動車メーカー側でニューラルネットワークのパラメータを微調整することも、独自の運転嗜好をソフトウェアに反映させることも許されませんでした。
もう一方は、圧倒的な汎用並列計算能力を誇るNVIDIAの「Drive Orin」モデルです。オープンなCUDAエコシステムと強力な演算性能によって自動運転アルゴリズムの先行開発を可能にしたものの、チップ単体で数十ワットに達する消費電力と液冷配管を必要とする熱設計、さらには極めて高額な調達コストは、普及価格帯の車両への搭載を阻む高い壁となって立ちはだかりました。
旧来の二大パラダイムの限界
- Mobileye(ブラックボックス型): アルゴリズムが硬直化しOEM独自の機能差別化が不可能。中国の週次OTA進化に追随できずシェア急落
- NVIDIA(汎用GPU型): 圧倒的なCUDA開発環境を誇る一方、TDP 65W超の液冷要件と高額なBOMコストが大衆車普及の足枷
地平線 BPU Nash の最適解
- アルゴリズム協調型DSA: Transformer/BEV/OccNetのデータフローに直結した専用テンソル&ベクトル演算回路
- 空冷対応とコスト破壊: 15万〜25万元(約300万〜500万円)の量産普及車に都市部NOAを実装できる電力・BOM効率
- オープンなTogetheROS: 自動車メーカーが自社アルゴリズムを自由に展開できるソフトウェア主権を提供
中国市場で吹き荒れる熾烈なEV価格破壊は、この二項対立に終止符を打ちました。15万元〜25万元(約300万円〜500万円)の量産ファミリーカーに高速道路のみならず都市部の自動運転ナビゲーション(City NOA)を標準搭載することが購買の絶対条件となる中、自動車メーカーが求めたのは「NVIDIA並みの柔軟なアルゴリズム開発環境」と「Mobileye並みの低消費電力・低BOMコスト」の奇跡的な両立でした。
百度(Baidu)の深層学習研究所(IDL)初代所長を務めた余凱(カイ・ユー)博士が2015年に創業した地平線は、まさにこの産業の歪みを突いて急成長を遂げました。
2. 主要車載AIコンピューティング・プラットフォームの技術・アーキテクチャ徹底比較
自動運転用SoCの競争軸は、単純な「カタログスペック上のTOPS値(1秒あたりの演算回数)」から、「実車環境におけるFPS/Watt(電力効率)およびFPS/Dollar(コスト効率)」へと劇的に移行しました。
主要プレイヤーの最新フラッグシップSoCを比較すると、各社が選択したアーキテクチャの思想の違いが鮮明になります。
📊 主要車載AI半導体・自動運転プラットフォームのスペック・アーキテクチャ比較
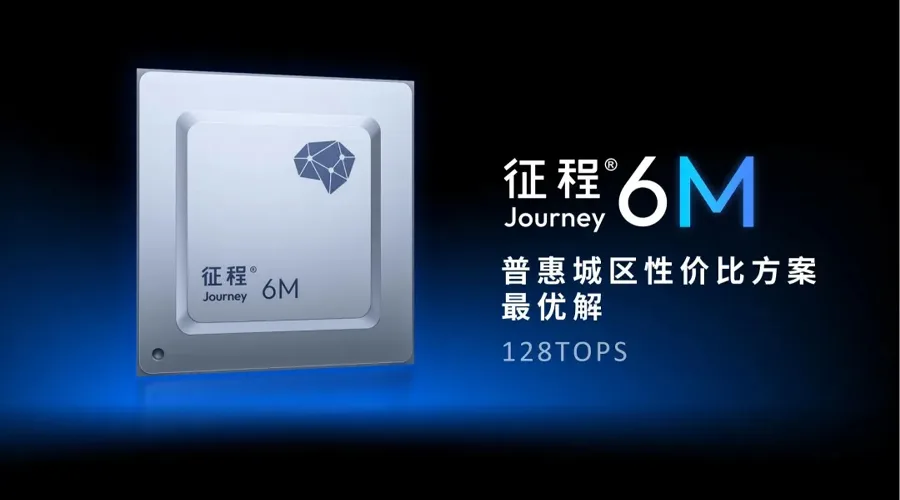
| 比較項目 | 地平線 (Horizon) 征程6P | 地平線 (Horizon) 征程6M | NVIDIA Drive Orin-X | Mobileye EyeQ6 High | クアルコム Snapdragon Ride (SA8650P) |
|---|---|---|---|---|---|
| 中核NPU構成 | BPU Nash (専用DSA) | BPU Nash (中階特化) | Ampere GPUコア + DLA | EyeQ専用アクセラレータ群 | Hexagon NPU + Adreno GPU |
| 最大公称計算資源 | 560 TOPS | 128 TOPS | 254 TOPS | 約34 TOPS (実効効率特化) | 約200 TOPS (スパース時) |
| Transformer演算効率 | ネイティブ処理(専用テンソルコア) | ネイティブ処理(軽量化対応) | CUDAコア並列処理 | 限定的対応(外部依存) | ベクトル拡張ユニット処理 |
| メモリ帯域幅 | LPDDR5x 8533Mbps | LPDDR5x | LPDDR5 204.8 GB/s | LPDDR5 | LPDDR5x |
| 標準消費電力 (TDP) | 約40W〜65W(空冷・液冷両対応) | 約15W〜20W(完全空冷) | 約65W〜75W(原則液冷必須) | 約10W〜15W(完全空冷) | 約30W〜50W |
| ソフトウェア開放度 | オープン(TogetheROS / アルゴリズム内製可) | オープン(標準スタック提供) | フルオープン(CUDA / DriveOS) | クローズド(一部SDK開放のみ) | セミオープン(QNX / Android連動) |
| 対応可能機能 | 都市部全シナリオNOA / VLAモデル | 高速NOA / 記憶駐車 / 先進ADAS | 都市部NOA / エンド・ツー・エンド | 高速道路運転支援(一部都市部) | 高速・都市部NOA |
| 採用実績 | VW (CARIAD), BYD, 吉利, 理想 | 奇瑞, 長安, 広汽, 上汽 | 小鵬, NIO, Xiaomi, Zeekr | Geely (Zeekr初期), 欧州OEM | GM, VW (一部), 欧米OEM |
この比較から明らかなように、地平線の「征程6」ファミリーの強みは、同一のアーキテクチャ(BPU Nash)と同一のツールチェーンを維持したまま、18 TOPS(征程6B)から128 TOPS(征程6M)、そして560 TOPS(征程6P)までシームレスにスケールできる「プラットフォームの広さ」にあります。
自動車メーカーは、エントリーモデルのアクティブセーフティから最上位モデルの都市部NOAまで、ソフトウェアコードの資産を完全に再利用しながら製品ライン全体へ展開できます。この開発資産の継承性が、莫大なソフトウェア開発費に苦しむ自動車メーカーにとって決定的な採用理由となっています。
3. BPU Nashの微小アーキテクチャ解剖:なぜ「アルゴリズム定義半導体」が勝つのか
半導体工学の視点から見て、地平線のBPU(Brain Processing Unit)が達成した最大のブレークスルーは、「アルゴリズム定義半導体(Algorithm-Defined Silicon)」という設計思想の具現化です。
地平線 BPU Nash アーキテクチャ
Transformer/BEVのデータフローに直結したDSA型車載AIエンジン
統合 Tensor Core
大行列積和演算器群とFP8/INT8動的量子化回路を内包し、スパース活性化により実効スループットを極大化
Vector Processing Core
Softmax、LayerNorm、RoPE(回転位置埋め込み)等の非線形関数をオンチップ上で単一サイクル連続処理
超低遅延スマートSRAM
近接メモリコンピューティングにより外部LPDDR5xメモリアクセスを40%削減し、消費電力と発熱を抑制
統一スケーラブル設計
18 TOPSのエントリーADASから560 TOPSの全シナリオNOAまで、単一ツールチェーン(TogetheROS)で資産継承
汎用GPUは、画像処理やグラフィックス描画のためのレジスタやキャッシュ階層を抱え込んでおり、ディープラーニング推論においてはチップ面積の少なからぬ割合が無駄なトランジスタ消費に充てられます。
対照的に、最新の「BPU Nash」は、近年の自動運転アルゴリズムの主流であるTransformerベースのBEV(Bird’s Eye View)およびOccNet(占有グリッドネットワーク)のデータフローに完全に一致するよう物理設計されています。
① 非線形関数演算器(Softmax / LayerNorm)のハードウェア直結
Transformerの自己注意機構(Self-Attention)において最大の計算ボトルネックとなるのは、行列積そのものではなく、アテンション重みを計算する「Softmax」やレイヤー正規化(LayerNorm)、回転位置埋め込み(RoPE: Rotary Position Embedding)などの非線形演算です。
汎用プロセッサでは、これらの処理が行われるたびにテンソル演算器から汎用CPU/GPUコアへデータを退避させ、キャッシュミスとレイテンシの爆発を招いていました。BPU Nashは、テンソルコアのパイプライン直近に高スループットのベクトル処理エンジン(Vector Core)を統合。中間特徴マップをオンチップから外部DRAMへ書き戻すことなく、単一サイクル内で連続処理するデータパスを確立しました。
② オンチップSRAMによる近接コンピューティングとDDR帯域幅の節約
車載半導体の消費電力の半分以上は、シリコンダイ内部の演算ではなく、外部のLPDDR5xメモリとの間で行われる高周波データ転送(I/Oバスの充放電)によって消費されます。
BPU Nashは大容量の超低遅延オンチップ分散SRAMを搭載し、ニューラルネットワークの重みパラメータと入力特徴量をオンチップ上に保持する「近接コンピューティング(Near-Memory Computing)」を徹底。外部DDRアクセスの頻度を従来世代比で40%以上削減することに成功しました。これにより、チップ全体の消費電力を劇的に抑え、熱設計の難易度を引き下げることに成功しています。
4. 独フォルクスワーゲンとの合弁「CARIZON」とグローバル展開の現実
地平線の台頭を語る上で、ドイツの自動車巨人フォルクスワーゲングループ(Volkswagen Group)との歴史的提携を外すことはできません。
2022年末、フォルクスワーゲン傘下のソフトウェア子会社CARIADと地平線は合弁会社の設立を発表。VW側は約24億ユーロ(当時の為替レートで約3,800億円)という巨額の資本を投じ、2023年末に合弁会社「CARIZON(酷睿程)」を北京で本格始動させました。
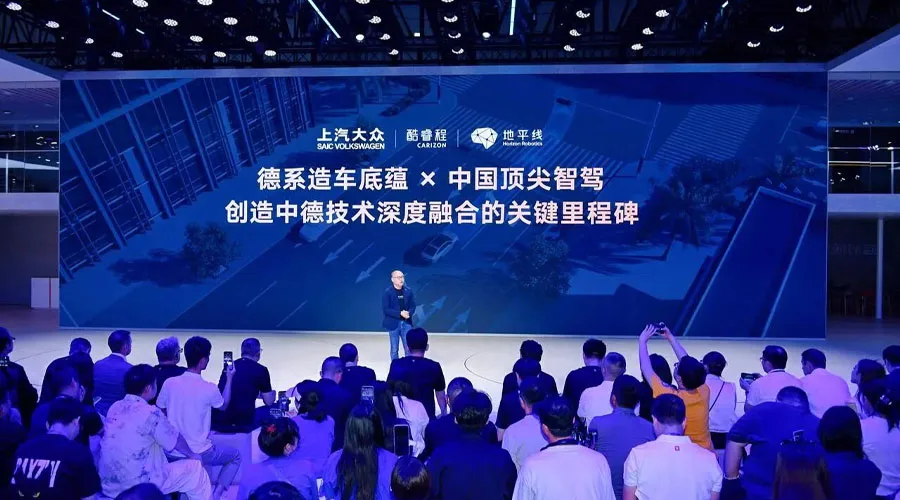
欧州随一の自動車メーカーが、自国のボッシュやコンチネンタル、あるいは米国のクアルコムやMobileyeではなく、中国のスタートアップを選んだ理由は明快でした。
中国市場において、フォルクスワーゲンの内燃機関(ICE)車や「ID.」シリーズEVは、ローカル新興勢力(BYD、理想、小鵬、Xiaomi)が繰り出す電光石火の車載インフォテインメントと自動運転機能の前に、急速なシェア低下に直面していました。本国のCARIADが開発するグローバル共通ソフトウェアプラットフォームは度重なる遅延に見舞われ、中国特有の複雑な都市道路(非保護左折、乱入する電動スクーター、複雑な立体高架)に到底適応できなかったのです。
CARIZONの設立により、フォルクスワーゲンは地平線のSoCとソフトウェア開発環境をベースに、中国現地で完結するアジャイル開発体制を獲得しました。
2026年後半、CARIZONが開発を主導した「中国市場専用の都市部NOA機能」を搭載したフォルクスワーゲンの新型セダンが量産ラインをロールアウト。これにより、外資系ブランドとして初めて中国の大都市圏で本格的なレベル2+自律走行を提供する体制を整えました。地平線にとっては、グローバルメガTier-1の品質管理基準と量産ノウハウを吸収し、世界基準のサプライヤーへと脱皮する決定打となったのです。
5. 1,500万枚出荷の裏側:BYD・理想・吉利を束ねる「量産エコシステムの堀」
車載半導体ビジネスの参入障壁は、チップの回路設計そのものよりも「過酷な自動車環境への適合」と「量産実績の積み上げ」にあります。
車載グレードの認証(AEC-Q100)や機能安全規格(ISO 26262 ASIL-D)の取得には通常3〜5年を要し、自動車メーカーは人命に関わる基幹部品において、トラックレコード(実走行での不具合ゼロ実績)のない新興チップセットの採用を極端に嫌います。
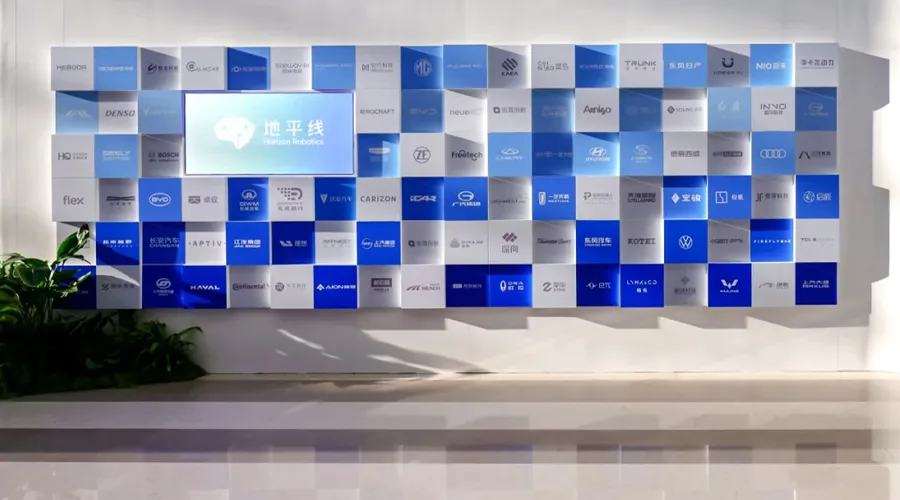
地平線がこの「鶏と卵」のジレンマを乗り越えられた背景には、中国EV市場の急速な立ち上がり期における国内自動車メーカーとの運命共同体的なアライアンス戦略がありました。
低価格帯での量産実績と安全認証の確立
征程2 / 征程3(5〜10 TOPS)を長安・広汽・奇瑞などに供給。Mobileyeの独占市場だった普及帯ADASで数百万台の実績を積み上げ、車載グレード信頼性を確立。
高速道路・都市部NOA市場での首位争い
征程5(128 TOPS)を理想汽車(Li Auto)のLシリーズやBYDの主力車へ量産配備。中国の高速NOA標準装備化の波に乗り、NVIDIAとの直接対決に突入。
単一アーキテクチャ・フルカバレッジと規模の経済
征程6B/6M/6Pにより国内外40社以上へ展開。VWとの合弁CARIZONによるグローバル量産と累計1,500万枚突破で、競合を寄せ付けない原価の堀を完成。
チップの出荷数が1,000万枚、1,500万枚と拡大するにつれて、TSMCなどの先端ファウンドリに対する製造委託コスト(ウェハあたりの単価)は劇的に低下します。この「規模の経済」がさらなる価格競争力を生み、競合他社が参入できないプライシングの堀(Moat)を形成しています。
また、地平線が提供するオープンプラットフォーム「TogetheROS」および開発ツールチェーン「天工開物(OpenExplorer)」は、Tier-1やOEM自社のアルゴリズムエンジニアが独自モデルを迅速にデプロイできる柔軟性を提供しています。ブラックボックスを嫌い、ソフトウェアの主権(Sovereignty)を自社で握りたいと願う先進OEMにとって、このオープンな開発姿勢が最大の求心力となっています。
6. SDV時代の半導体主権:水平分業の限界と車載アーキテクチャの未来
地平線のJourney 6シリーズが切り拓く車載AI半導体の現実から、日本の自動車産業や半導体・エレクトロニクス企業は何を学び取るべきでしょうか。
第一の教訓は、「自動車の付加価値の中心が、機械構造からシリコンとアルゴリズムの協調設計へ完全に移行した」という不可逆な現実です。
これまで日本の自動車産業は、デンソーやアイシンといった巨大Tier-1がECU(電子制御ユニット)をブラックボックスとしてまとめ上げ、自動車メーカーが全体のすり合わせを行う水平・垂直混成モデルで強さを誇ってきました。しかし、車両全体が数個の集中型HPC(ハイパフォーマンス・コンピュータ)によって統括されるSDV時代において、数十個の個別ECUを分散配置する旧来の手法は、配線重量、部品コスト、何よりもOTA(Over-The-Air)による機能更新の俊敏性において破綻を迎えています。
第二の教訓は、「汎用半導体の購入だけでは、中国勢の圧倒的な開発スピードとコスト競争力に対抗できない」という点です。
欧米や日本のメーカーがNVIDIAの最高峰SoCを高額で購入し、分厚い冷却システムと格闘している間に、中国勢は地平線のようなローカルSoCパートナーと手を組み、自社の車両セグメントに過不足のない専用DSAを安価に実装して、月単位でアルゴリズムを刷新しています。
すでにトヨタ自動車も中国現地市場においては、グローバル共通の設計思想から一歩踏み出し、中国ローカルのインテリジェント運転サプライヤーや半導体プラットフォームとの提携を急速に深めています。
/blog/2026/08/unitree-g1-commercial-battle-mass-production/のフィジカルAIロボティクスや、/blog/2026/08/bambu-lab-high-speed-3d-printer-moat/の先鋒ハードウェアと同様に、中国のテック企業は「泥臭いハードウェアの製造力」と「極限まで洗練されたソフトウェア・アルゴリズム」を単一の組織体の中で融合させる能力において、世界で最も先鋭化しています。
単なる「格安チップ」の枠を超え、独フォルクスワーゲンをも巻き込んだ巨大エコシステムを築き上げた地平線。同社が推進する車載AI半導体の量産競争は、モビリティの未来を誰が支配するのかという、グローバル産業史の転換点を鮮明に映し出しています。
「半導体とは、シリコンに刻まれたアルゴリズムの具現化である。ハードウェアの真の目的はスペックシートの数字を競うことではなく、アルゴリズムが物理世界を理解し、人間を安全かつ快適に目的地へ運ぶためのエネルギー効率を極限まで高めることにある」—— 余凱(Kai Yu), 地平線(Horizon Robotics)創業者兼CEO
コメント
...