1. 非構造化データの未踏峰:オラクル中枢エンジニアが下した「異端の独立」
2016年、米カリフォルニア州レッドウッドショアーズのオラクル(Oracle)本社。エンタープライズ・リレーショナルデータベース(RDBMS)の絶対王者として君臨する巨大企業の中心部で、一人の中国人エンジニアが奇妙な焦燥感に囚われていました。
彼の名は星爵(本名:査秉毅 / Charles Xie)。オラクル屈指の精鋭が集まるマルチテナント・データベースエンジン「Oracle 12c」の開発チームにおいて、中核アーキテクトとして多大な成功を収めていた男です。数万社に及ぶ世界中の大企業が、売上データや在庫リスト、顧客台帳といった「行と列」で表される構造化データをオラクルのデータベースに預け、莫大なライセンス料を払い続けていました。
しかし、星爵氏の目には、その巨塔がすでに過去の遺物に向かっているように見えていました。
【人類が生み出すデータの現実】
■ 構造化データ(表・数値・リレーショナルDB): 全データのわずか 10〜20%
■ 非構造化データ(画像・音声・動画・自然言語・センサー): 全データの 80%以上画像、動画、音声、そして無数の自然言語テキスト。深層学習(ディープラーニング)のブレイクスルーによって、これら「非構造化データ」がデジタル世界を津波のように覆い尽くそうとしていました。それらのデータは、従来のSQLやリレーショナルテーブルには決して収まりません。AIモデルがデータを理解する唯一の共通言語は、高次元の浮動小数点配列――すなわち「埋め込みベクトル(Vector Embeddings)」でした。
「オラクルのような既存の巨大リレーショナルDBに、ベクトルの検索機能をおまけとして継ぎ足しても、根本的な解決にはならない。非構造化データそのものを第一級市民として扱い、数十億次元の類似性をミリ秒で検索できる専用のデータ基盤が絶対に必要になる」
「データベースの歴史は半世紀にわたりリレーショナルが支配してきた。だがAIが人類の知能を拡張する時代、データの8割以上はテーブルに収まらない。我々は非構造化データのための新たなOSを創る」
―― 星爵(Charles Xie / Zilliz 創業者兼CEO)周囲の同僚たちは「AI専用のデータベースなど、ニッチすぎて市場が存在しない」と一笑に付しました。当時、機械学習エンジニアたちは手元のPythonスクリプト上でNumPy配列やMetaのFAISS(Facebook AI Similarity Search)ライブラリを直接呼び出し、インメモリで検索を済ませていたからです。データベースとして独立したシステムを作るなど、商業的に成立するはずがないと考えられていました。
しかし星爵氏は確信していました。データ量が数百万、数億件を超え、数百人のユーザーが同時にリアルタイム検索を要求した瞬間、インメモリの単一マシン用ライブラリは破綻する――。
2017年、彼はシリコンバレーの安定した高給とオラクルの要職を捨て、上海でZilliz(ゼット・アイリス / 上海点算信息科技)を創業しました。創業チームは最初の2年間、売上ゼロのまま、ひたすら未知のベクトル処理エンジンの設計図を引き続けました。それが後に、世界中のAI開発者コミュニティを揺るがすことになるオープンソース・ベクトルデータベース「Milvus(ミルバス)」の原型です。
2. オープンソースという博打:Milvusの寄贈とGitHub 3万スターの狂熱
インフラ系ソフトウェアのスタートアップにとって、最も困難な問いは「どうやって最初の1社に信頼してもらうか」です。特にミッションクリティカルなデータを扱うデータベースの世界では、実績のない無名ベンチャーのプロプライエタリ(クローズド)製品を本番環境に導入してくれる大手企業など存在しません。
星爵氏が下した決断は、極めて大胆な「完全オープンソース化」でした。2019年、Zillizは開発の結晶であるMilvusのコードをApache 2.0ライセンスでGitHub上に全公開しました。
さらに2020年、同社は業界を驚かせる行動に出ます。Milvusの知的所有権とプロジェクトのガバナンスを、非営利団体であるLinux Foundation傘下の「LF AI & Data Foundation」に無償寄贈したのです。中国発のスタートアップが自社のコア知財を国際的なオープンソース財団に手放すことは、当時極めて異例の選択でした。
【なぜ自社のコア知財を財団に寄贈したのか】
1. 中立性の担保:単一企業の意向でライセンス変更されない保証を与え、グローバル開発者の懸念を払拭
2. エンタープライズの心理的障壁の撤廃:特定ベンダーへのロックインを嫌うフォーチュン500企業の導入を加速
3. デファクトスタンダードの先制獲得:競合他社が参入する前に「ベクトルDB=Milvus」のマインドシェアを固める
この「完全なオープン性」は、驚異的なエコシステム効果を生み出しました。世界中の研究機関、機械学習エンジニア、自動運転開発チームがMilvusのリポジトリに集結。GitHubスター数は急増し、LF AI & Data Foundationにおいてトップティアの「卒業(Graduated)プロジェクト」へと認定されました。
オラクルを離脱、Zillizの創業
オラクル米国本社で12cマルチテナントDBを手掛けた星爵(チャールズ・ツァオ)が独立。「非構造化データ処理」を旗印に上海でZillizを設立。
世界初の分散型ベクトルDB「Milvus」オープンソース公開
AIの埋め込みベクトルに特化したデータベースとしてMilvus 1.0をGitHubで公開。瞬く間にグローバル開発者コミュニティで話題を集める。
Linux Foundation(LF AI & Data)への完全寄贈
特定企業による囲い込みの懸念を払拭するため、LF AI & Data FoundationにMilvusを寄贈。後に最上位の卒業(Graduated)プロジェクトへと昇格。
クラウドネイティブ版Milvus 2.0投入とサウジアラムコからの巨額調達
計算とストレージを完全分離したMilvus 2.0を発表。サウジアラムコ傘下のProsperity7主導で6,000万ドル(シリーズB+)を調達。
ChatGPTとRAG狂乱:Zilliz Cloudの本格商用ローンチ
AWS、Google Cloud、Azure上で完全マネージドサービス「Zilliz Cloud」の一般提供を開始。Pineconeやpgvectorとの熾烈な市場争奪戦が激化。
AIエージェントの外部脳へ:「DeepSearcher」と自律推論の時代
単純なキーワード類似検索から、自律型AIエージェントの長期記憶・多段階推論プラットフォームへと進化。エヌビディアやグローバル金融大手での本番稼働が拡大。
2022年、Zillizはサウジアラビアの国営石油会社サウジアラムコ傘下のベンチャーキャピタル「Prosperity7 Ventures」やシンガポールのテマセク子会社「パビリオン・キャピタル(Pavilion Capital)」、高瓴資本(Hillhouse Capital)などから累計1億1,300万ドル(約170億円超)の資金調達を完了しました。評価額は6億ドル(約900億円)規模に達し、世界で最も資本力を備えたベクトルDB専業プレイヤーとしての基盤を固めたのです。
しかし、オープンソースのコミュニティがどれほど熱狂しようとも、それは1ドルの売上も保証してくれません。オープンソースの熱狂を、いかにして持続可能なキャッシュフローに変換するのか――。Zillizの前には、インフラソフトウェア業界の先人たち(MongoDB、Elastic、Confluent)が幾度となく直面してきた「過酷な商業化の谷」が口を開けて待っていました。
3. 「pgvector」とクラウド巨人の無料包囲網:特化型ベクターDBの生存危機
2023年春、OpenAIが「ChatGPT」を全世界に解き放った瞬間、ベクトルデータベースは一躍、テクノロジー業界で最も脚光を浴びるキーワードとなりました。
大規模言語モデル(LLM)は「幻覚(ハルシネーション)」を起こしやすく、学習データの締め切り以降の最新情報や、社外秘の社内ナレッジを知りません。この致命的な弱点を埋める処方箋として浮上したのが、RAG(Retrieval-Augmented Generation / 検索拡張生成)でした。社内文書やマニュアルをベクトル化してデータベースに格納し、ユーザーの質問に関連する情報を検索してプロンプトに注入する――。すべての企業が「RAG構築」に雪崩を打ったことで、ベクトルDBの需要は垂直立ち上がりを見せました。
だが、この熱狂の最中、ZillizとMilvusの背後には冷酷な「包囲網」が音を立てて狭まっていました。
最大の脅威は、新興の競合ベンチャーではありませんでした。オープンソースのリレーショナルDB界の絶対王者、PostgreSQLが繰り出した一本の拡張プラグイン――「pgvector」でした。
-- 既存のPostgreSQLにたった1行追加するだけで、ベクトル検索が動き出す
CREATE EXTENSION vector;
世界中のIT部門にとって、すでに何年も運用し、バックアップ体制もセキュリティ監査も完了しているPostgreSQL。そこにたった1行のコマンドを打つだけで、ベクトル検索機能が手に入ったのです。「なぜわざわざ、得体の知れない新しい特化型ベクトルDBを別途導入し、追加の運用コストを払わなければならないのか?」という疑問が、世界中の企業のCIOや開発リーダーの脳裏をよぎりました。
さらに、クラウドの巨人たちも一斉に牙を剥きました。アマゾン ウェブ サービス(AWS)は「OpenSearch」にベクトル検索エンジンを追加し、Microsoft Azureは「Cosmos DB」や「Azure AI Search」にベクトル機能を統合。Google Cloudも「AlloyDB」や「Vertex AI」にベクトル拡張をバンドルしました。既存のクラウド契約の枠内で「おまけ」として配られるベクトル機能に対し、Zillizのような特化型スタートアップが単体で課金することは極めて困難に見えました。
「特化型ベクトルデータベースは一過性のバブルであり、最終的には既存の汎用DBに飲み込まれて消滅する」――シリコンバレーの著名アナリストや投資家たちは、公然とそう囁き始めました。
PostgreSQL+pgvector(汎用DB拡張)の限界
- メモリ消費とインデックス肥大化:高次元ベクトル(1,536次元等)のHNSWインデックスがRAMを圧迫し、通常のリレーショナル処理のキャッシュを阻害。
- 大規模データでのレイテンシ急落:数千万件を超えるデータ規模ではインデックス再構築(VACUUM/REINDEX)に数時間〜数日を要し、高QPS下でスループットが崩壊。
- 計算とストレージの未分離:スケールアウト時にリレーショナルエンジン全体の複製が必要となり、クラウドのインフラ費用(TCO)が爆発的に増大。
特化型ネイティブ・ベクトルDBの設計優位性
- 完全な計算・ストレージ分離アーキテクチャ:MinIO/S3などのオブジェクトストレージを活用し、クエリノードとインデックスノードを独立して無停止スケール。
- C++コアとGPUアクセラレーション:ベクトル検索エンジン「Knowhere」がAVX-512やNVIDIA cuVSを直接制御し、数十億件規模でもミリ秒台の近似近傍探索(ANN)を実現。
- マルチテナントとAIネイティブ機能:パーティション分割、動的スキーマ、ベクトルとスカラー属性のハイブリッドフィルタリングを低レイテンシで両立。
Zillizのエンジニアリングチームは、この批判に技術の牙で応戦しました。
星爵氏が看破していた通り、「10万件程度のプロトタイプ検証」であれば、pgvectorや汎用DBのベクトル機能で十分です。しかし、企業のAI活用が本番フェーズへと進み、データが「数千万件から数十億件」へと膨れ上がった瞬間、汎用DBは物理的な壁に激突します。
高次元ベクトルの近傍探索アルゴリズム(HNSWなど)は、膨大なメモリ空間をランダムに走査します。既存のリレーショナルDBにこの負荷をかけると、メインメモリが食いつぶされ、通常のトランザクション処理までフリーズしてしまうのです。また、インデックスの再構築には何日もかかり、システムメンテナンスの間、検索サービスは停止を余儀なくされます。
これに対し、Milvus 2.0以降のアーキテクチャは、最初から「クラウドネイティブな計算・ストレージ分離」を前提にゼロから構築されていました。
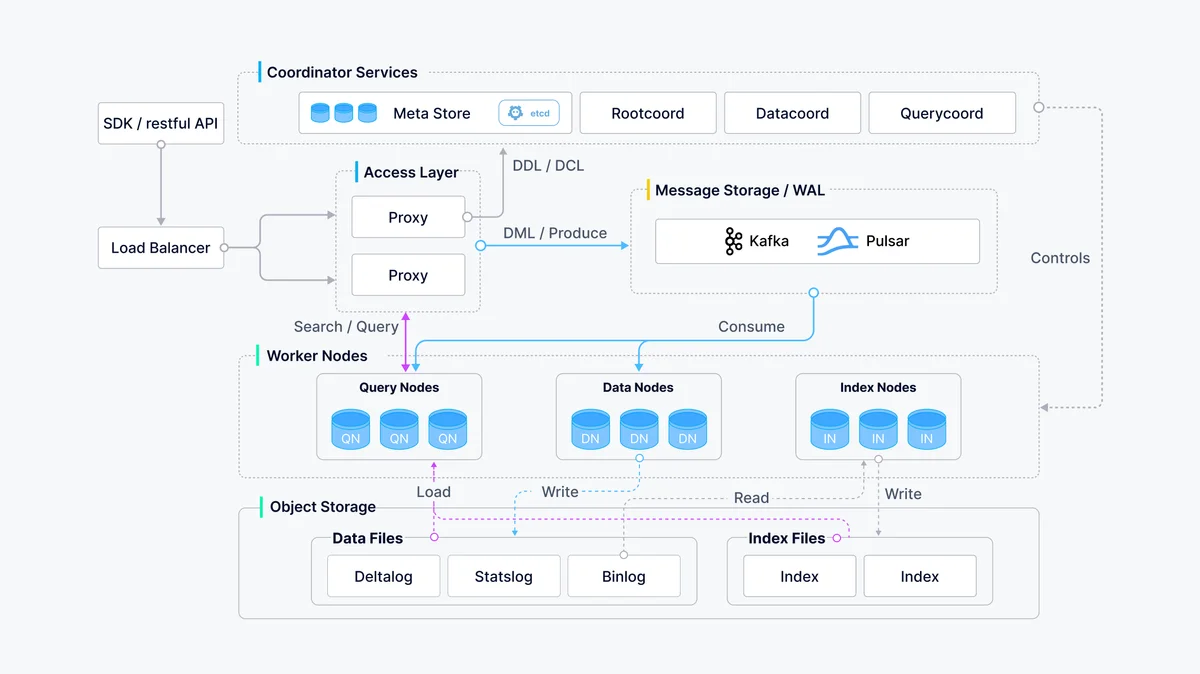
データを安価なオブジェクトストレージ(AWS S3やMinIO)に預け、検索計算を行うクエリノード(Query Node)と、重いインデックス構築を行うインデックスノード(Index Node)を物理的に分離。突発的なアクセスの急増にはクエリノードだけを数秒で水平スケールアウト(複製追加)し、検索トラフィックが落ち着けば縮小する――。
このアーキテクチャにより、10億件以上の大規模ベクトルを抱える本番環境において、Zillizは汎用DB拡張に比べてハードウェア費用(TCO)を3分の1から5分の1に削減し、クエリレイテンシを10ミリ秒以下に抑え込むという圧倒的な性能差を叩きつけました。「安上がりなおまけ」で済ませようとして本番障害に直面したエンタープライズ企業が、次々とZillizのドアを叩き始めたのです。
4. 理想から現実への転換:マネージドSaaS「Zilliz Cloud」の課金攻防戦
しかし、技術的優位性を証明することと、企業から安定的にお金を回収することはまったくの別問題です。ここからZillizの最も過酷なビジネスリアリズムが始まりました。
開発者たちはオープンソースのMilvusを愛していました。自分のラップトップ上でdocker runを叩けば、誰にも文句を言われず無料で動かせるからです。しかし、それではZillizに1銭も入りません。無料ユーザーの数万のスターや数百万のダウンロード数を、いかにして有料SaaSのARR(年間経常収益)へと転換するか。
Zillizが立ち上げたマネージドクラウドサービスが「Zilliz Cloud」でした。
米シリコンバレーの最大のライバルであるPineconeは、最初からコードを一切公開せず、完全なプロプライエタリ(閉源)SaaSとして開発者に「月額課金」を強制するモデルを選びました。その結果、手軽なAPIを求める米国の個人開発者やシード期のスタートアップを素早く囲い込み、巨額の評価額を手にしました。
一方のZillizは、「オープンソース版Milvus(セルフホスト)」と「Zilliz Cloud(フルマネージド)」という二重構造(デュアルコア戦略)を維持する道を選びました。このモデルには、特有の苦渋の駆け引きが存在します。
【オープンソース企業が直面する社内カニバリゼーションの罠】
・オープンソース版を便利にしすぎると、誰も有料クラウドに移行しない
・オープンソース版の機能を意図的に制限すると、開発者コミュニティから「裏切り」と猛烈な批判を浴びるZillizが下した解決策は、機能制限による締め出しではなく、「エンタープライズの運用負荷(Day-2 Operations)の徹底的な肩代わり」でした。
数十台のKubernetesノード上で動く分散データベースの運用、ダウンタイムなしのローリングアップデート、マルチAZ(アベイラビリティゾーン)での高可用性バックアップ、SOC 2 Type IIやISO 27001、HIPAAといった厳格なセキュリティ・コンプライアンス認証――。これらを自社のインフラチームで内製すれば、専任のSRE(サイト信頼性エンジニア)を数名雇う必要があり、年間で数千万円の人件費が吹き飛びます。
「自前でMilvusクラスタを運用する人件費とトラブル対応のコスト」と「Zilliz Cloudに支払うマネージド利用料」を天秤にかけさせ、圧倒的に後者の方が安上がりであることを数字で提示する営業戦略へと舵を切ったのです。
| 評価軸 | Zilliz Cloud(Milvus) | Pinecone | PostgreSQL(pgvector) | クラウド巨人(AWS OpenSearch等) |
|---|---|---|---|---|
| 提供形態 | オープンソース+マネージドSaaS | 完全クローズドSaaS | オープンソース(拡張) | クラウド従量課金サービス |
| 対応データ規模 | 100億件超(超大規模に最適化) | 数千万〜数億件 | 数百万〜数千万件が限界 | 数千万〜数億件 |
| アーキテクチャ | 完全な計算・ストレージ分離 | クラウドネイティブ | モノリシック(統合型) | 既存検索エンジンの拡張 |
| マルチクラウド | AWS、GCP、Azure完全対応 | AWS、GCP、Azure | どこでも稼働 | 自社クラウドにロックイン |
| ハードウェア加速 | GPU(cuVS)/ AVX-512 | 一部独自アクセラレータ | CPUのみ | CPU中心(一部独自チップ) |
| ターゲット層 | グローバル大企業・AIネイティブ企業 | 北米スタートアップ・個人 | 中小アプリ・プロトタイプ検証 | 既存クラウドアカウント企業 |
さらに、Zillizは「クラウドマーケットプレイス」への徹底的な統合を進めました。企業のCIOが新規の海外ベンダーと個別にベンダー登録契約を結ぶのは法務的に極めてハードルが高い作業です。そこでAWS MarketplaceやGoogle Cloud Marketplace経由で、企業が既存のクラウドアナリティクス予算(コミットメント枠)をそのまま使ってZilliz Cloudを1クリックで購入できるようにしたのです。
このリアリズムに基づく営業戦略の転換により、Zilliz Cloudの顧客基盤は劇的に変貌しました。
単なる個人のAI愛好家から、エヌビディア(NVIDIA)、セールスフォース(Salesforce)、eBay、ウォルマート(Walmart)、さらには通信大手や米国の金融コングロマリットといった世界屈指のエンタープライズへと顧客層がシフト。日本市場においても、通信キャリアや大手メガバンクが、生成AI社内アシスタントや不正検知のバックエンドとしてZilliz Cloudの採用を進めるようになりました。
オープンソースのコミュニティに無償で貢献しながら、ピラミッドの頂点にいるフォーチュン500企業から数千万円〜数億円単位の年間契約(ARR)を回収する――。Zillizは、中国発のインフラソフトウェアとして前例の極めて少ない、真の「グローバル・マネタイズモデル」を軌道に乗せ始めたのです。
5. RAGの終焉とAIエージェントの外部脳:100億次元が描くインフラの地平
しかし、AIインフラの進化スピードは、一息つく猶予すら与えてくれません。2025年から2026年にかけて、AI業界全体を揺るがす新たなパラダイムシフトが勃発しました。
「単純なRAGの終焉」と、「自律型AIエージェント(Agentic AI)」の台頭です。
かつてのRAGは単純でした。「ユーザーのプロンプトをベクトル化し、最も距離の近い3つのドキュメントを引っ張ってきてLLMに読ませる」。この原始的なベクトル検索は、確かに定型的なFAQ対応には役立ちました。しかし、企業が本当に解きたい複雑な業務課題――たとえば「競合他社5社の過去3年分の決算短信を横断比較し、サプライチェーンの脆弱性を洗い出せ」といったタスクには手も足も出ませんでした。
さらに、中国のDeepSeekの推論革命や米OpenAIの「o1/o3」に代表される「推論型モデル(Reasoning Models)」が登場したことで、LLMは単なるテキスト生成器から「自ら推論ステップを組み立てて試行錯誤する頭脳」へと変貌しました。
AIが求める「記憶」の定義そのものが、根底から書き換わったのです。
【AIが求める「記憶」のパラダイム変化】
■ 従来のRAG(2023〜2024):
  静的ドキュメントの単発検索(「この規則はどうなっていますか?」)
  ⬇️
■ エージェントの長期記憶(2025〜2026):
  過去の思考ログ、ツールの実行結果、反省と検証の履歴を永続化し、
自律的に複数ステップを検索・推論する「外部脳(Long-Term Memory)」星爵氏率いるZillizは、この地殻変動に対してもいち早く先手を打ちました。単なる受動的なデータベースにとどまらず、自律推論エージェントと密結合した新たなフレームワーク「DeepSearcher(ディープサーチャー)」などのオープンソースツールを相次いで投入。AIエージェントが自らクエリを分割し、ベクトル空間とナレッジグラフを縦横無尽に行き来しながら「事実のクロスチェック」を自律的に繰り返す基盤を構築したのです。
Zilliz Cloud / Milvus Core
数十億ベクトルのミリ秒検索を担うAI長期記憶エンジン
LLMオーケストレーション
LangChain、LlamaIndex、DSPyと連携し、コンテキスト窓を超える外部知識注入と推論コンパイルを実行。
NVIDIA GPU / cuVS
GPUアクセラレーションによる超高速インデックス構築。数千万件のベクトル追加を数分で処理しTCOを半減。
データレイク・クラウド連携
AWS S3、Snowflake、Apache Iceberg上の非構造化データを埋め込みモデル(Embedding)を通じて自動同期。
Agentic Memory & DeepSearch
DeepSearcher等の自律探索エージェントが多段階クエリを自律生成し、事実確認と意思決定の精度を極限まで向上。
ハードウェアの進化もこの流れを後押ししています。エヌビディア(NVIDIA)が提供するGPUベクトル検索ライブラリ「cuVS」とのネイティブ統合により、ZillizはCPUベースのインデックス構築に比べて10倍以上のスループットを達成。数千万件のリアルタイムデータ追加が毎秒発生するような自律運転フリートの遠隔解析や、リアルタイム金融不正検知システムにおいても、一切の遅延なくベクトル空間を更新し続ける能力を手に入れました。
6. 世界市場で生き残るインフラソフトウェアの条件
オラクルの快適なオフィスを飛び出し、誰も信じなかった「ベクターDB」という荒野を開墾し始めた星爵氏とZillizの旅路は、世界のテクノロジー産業に極めて重厚な教訓を投げかけています。
日本のエンタープライズITの世界でも、長年にわたりオラクルやPostgreSQLといったリレーショナルデータベースが業務の絶対的な支柱であり続けてきました。多くの企業が現在、既存の基幹システムの上に「生成AIとRAGのPoC(概念実証)」を継ぎ足そうと奮闘しています。しかし、データ量が爆発し、AIが単なる質問応答から「自律エージェント」へと進化する過程で、従来のデータベース構造の限界に直面することは避けられません。
Zillizが示した生存戦略は、明快かつ冷徹です。
第一に、「オープンソースは目的ではなく、世界標準への最速のバイパスである」ということ。もしZillizが最初からクローズドなソフトウェアとしてMilvusを販売していたなら、米中の地政学的緊張やスタートアップへの不信感に阻まれ、シリコンバレーや日本の大企業に食い込むことは不可能だったでしょう。知財を財団に寄贈してまで中立性を貫いたからこそ、グローバルな信頼を勝ち得ることができました。
第二に、「無料の熱狂に酔わず、エンタープライズの痛点に冷徹に課金する」ということ。どれほどGitHubで絶賛されようと、顧客の「ダウンタイムの恐怖」「インフラ費用の膨張」「セキュリティ監査の工数」というリアルな痛みに直結しなければ、ソフトウェア企業は飢え死にします。Zilliz Cloudは、そのリアリズムに徹底的に殉じることで、無料の包囲網を突破しました。
第三に、「コモディティ化の津波が追いつく前に、次の次元へ逃げ切る」ということ。PostgreSQLやクラウド大手が単純なベクトル検索を「おまけ」として無料配布し始めたとき、Zillizはすでにマルチモーダル検索、GPUアクセラレーション、そしてAIエージェントの長期記憶という「次の未踏峰」へとシフトしていました。巨人が真似できる機能にとどまっている限り、インフラソフトウェアの寿命は数年で尽きるのです。
リレーショナルデータベースが半世紀かけて築き上げた世界を、AIのベクトル空間が再定義しようとしています。100億次元の数学的空間の中で、世界中の知能をリアルタイムに結びつけるインフラの覇権争い。ZillizとMilvusが繰り広げる収益戦は、AI時代の「ソフトウェアの勝ち方」を示す最も生々しいケーススタディとして、これからも世界の開発者と投資家の視線を引きつけ続けるはずです。
参考資料・情報元
- [一次情報] Zilliz Official:Making Sense of Unstructured Data with Founder and CEO Charles Xie
- [一次情報] LF AI & Data Foundation:Milvus Project Graduation and Open Source Ecosystem
- [一次情報] SiliconANGLE:Zilliz extends Series B with $60M led by Prosperity7 for vector database expansion
- [一次情報] Milvus Documentation:Cloud-Native Distributed Vector Database Architecture v2.4
コメント
...