1. 金融街と法律事務所の日常を変えた「200万字の魔力」
北京の金融街(金融街)や上海の陸家嘴(陸家嘴)のオフィスビル。夜遅くまで明かりが灯る投資銀行や大手法律事務所のデスクで、アナリストや弁護士たちがブラウザのタブに常駐させているのは、汎用の検索エンジンでも、大手IT企業が提供する一般的なAI対話ツールでもありません。
彼らが日常の起点に置いているのは、AIスタートアップ月之暗面(Moonshot AI)が開発した「Kimi(Kimi智能助手)」です。
業務の分断と文脈欠落
- 機械的チャンク分割: 500ページのIPO目論見書や財務諸表を数十ページずつ断片化してベクトル化
- コンテキスト喪失: 章をまたぐ財務注記や契約の例外規定が分断され、重要なリスク条項を見落とし
- 現場の不信感: 「どこを参照したか分からない」「微妙にニュアンスが違う」誤読や幻覚が多発
業務直結の超高速網羅抽出
- 200万字一括投入: IPO目論見書・3年分決算短信・業界レポートを丸ごとプロンプトへダイレクト装填
- 完全な文脈保持: ドキュメント全体の整合性と相互参照関係を崩さず、数秒で全相違点・リスク条項を網羅
- プロの業務直結: 弁護士やアナリストが泥臭く手作業で行っていた照合作業を瞬時に完了
かつて1件のIPO審査やM&Aデューデリジェンスを行う際、アナリストは数百ページにおよぶ開示資料や財務レポートを何日もかけて読み込み、矛盾する数字や隠れた債務条項を手作業で照合していました。従来のAIツールでは、入力できるトークン数の制約から文書を細かく裁断して投入せざるを得ず、前後の文脈が分断されて肝心なリスク分析を見落とす危険が常につきまとっていたためです。
この知的労働のボトルネックに対し、Kimiが提示したのは「200万字(約200万トークン)の文書をそのまま丸投げし、数秒で全容を把握する」という圧倒的な体験価値でした。
契約書の条項間の齟齬の発見、複数企業の財務指標のクロス集計、難解な法規制の変更点抽出——オフィスワーカーが直面する泥臭く時間のかかる業務を瞬時に解決する実力は、中国の知的労働者層に強烈な「Kimi依存症」を生み出しました。2024年春にアクセスが殺到してサービスが一時停止した際、SNS上で「Kimiが動かないと業務が完全に停止する」と現場のプロフェッショナルから悲鳴が上がった事実は、単なる流行を超えた本質的なプロダクト・マーケット・フィット(PMF)を証明しています。
2. 創業者・楊植麟の「第一性原理」:大手プラットフォームの包囲網をどう突破したのか
中国の生成AI市場は、極めて過酷なレッドオーシャンです。Alibaba、Tencent、ByteDanceといった巨大プラットフォームが、潤沢なパブリッククラウドの余剰コンピューティング資源を背景に100万トークン数銭レベルの苛烈なAPI価格破壊を仕掛け、専業スタートアップを兵糧攻めに追い込んできました。
また、同じ清華大学発のスタートアップである智譜AIが国有企業や金融機関へのオンプレミスSI構築(重交付型受託)によって巨額売上を確保し香港IPOへ舵を切る中、月之暗面を創業した楊植麟(Yang Zhilin)氏が下した決断は、受託開発を一切排除し「コンテキスト長とプロダクト体験の極限追求」へ全リソースを集中させることでした。
📊 中国主要AIプレイヤーの戦略的ポジショニング比較
| 企業 / サービス | 主力戦略 | コア優位性 | トレードオフ / 課題 | 主要ターゲット層 |
|---|---|---|---|---|
| 月之暗面 (Kimi) | 超長文コンテキスト × 自律推論 | ホワイトカラー層でのマインドシェア独占、圧倒的長文保持力 | クラスタ運用コスト、B向け直接営業部隊の不在 | 金融、法務、コンサル、研究職、開発者 |
| ByteDance (豆包) | トラフィック連携 × API極限価格破壊 | TikTok/抖音エコシステム、火山エンジンのスケジューリング | 業務特化の深い思考力より大衆向け消費体験 | 一般コンシューマー、中小アプリ事業者 |
| 智譜AI (GLM) | エンタープライズ重交付 × 国産半導体対応 | 官公庁・金融へのオンプレミス構築実績、手厚いSI | 労働集約的になりやすく粗利率が低下しやすい | 大手国有企業、地方政府、金融基幹 |
| DeepSeek | 極限アルゴリズム革新 × 完全オープンソース | MLA/MoEによる超低コスト推論、グローバル開発者熱狂 | 自社C向けブランド認知よりAPIインフラ供給 | グローバルAI研究者、自律エージェント開発企業 |
楊植麟氏は、清華大学計算機系を優秀な成績で卒業後、米国カーネギーメロン大学(CMU)で博士号を取得。Google BrainやMeta AIの研究者らとともに、トランスフォーマーの長文処理の歴史的マイルストーンとなった論文「Transformer-XL」や「XLNet」の筆頭著者として名を馳せた、世界の自然言語処理(NLP)分野におけるトップリサーチャーです。
楊氏の第一性原理は明快でした。 「コンテキストの長さは、単なる仕様の数字ではない。それは人間の思考プロセスそのものの拡張であり、コンピュータと人間の最も自然なインターフェースである」
ユーザーに面倒なプロンプトエンジニアリングや検索キーワードの選定を強いるのではなく、思考の文脈をそのまま受け止める受け皿を用意する。この技術信仰に基づき、マーケティング予算を派手な広告宣伝ではなく長文推論の安定化とモデル改善に投じ続けたことが、大手の資本攻勢に対抗する最大の防壁となったのです。
3. 工学的な勝負手:なぜ200万字の推論コストで破綻しなかったのか?
長文コンテキストの提供は、AIインフラの観点からは悪夢のようなエンジニアリング課題を突きつけます。
トランスフォーマーのSelf-Attention(自己注意機構)は、入力系列長 $N$ に対して計算量とメモリ消費量が $O(N^2)$ で増大します。200万字ものコンテキストをナイーブにGPUメモリへ展開すれば、わずか数回のクエリでハイエンドGPUクラスタ(NVIDIA H100やH800)のHBM(広帯域メモリ)は枯渇し、1回あたりの推論原価が数百円に跳ね上がってサービス継続は不可能になります。
Moonshot AIがこの物理的限界を打破し、無料〜低価格での提供を両立させた背景には、3つの工学的ブレイクスルーが存在します。
階層型Prefix Caching(プレフィックス共有)
共有ドキュメント(社内規約・過去決算書など)のKVキャッシュをGPU HBMおよびホストDRAMに階層保存。同一文書に対する2回目以降のPrefill計算量をゼロ化し、最大92%の計算リソースを削減。
Prefill / Decode 完全物理分離(PD分離)
長文の一括解析(Prefill=計算バウンド)は計算特化型GPUノードで超高速処理し、トークンの逐次生成(Decode=メモリ帯域バウンド)はメモリ帯域特化型ノードへ委譲。トークン生成ジッターを根絶。
動的スパースアテンション + MoEルーティング
長文全体の中から出力に寄与する重要トークン間アテンションのみを動的に枝刈り。専門エキスパートのみを選択的に発火させ、150ms以内の高速ファーストトークン応答と推論原価90%圧縮を両立。
① 階層型Prefix CachingによるPrefill計算の蒸発
エンタープライズの現場では、同じドキュメント(例えば社内就業規則、直近の業界白書、標準契約約款など)に対して複数の質問を繰り返す行動パターンが顕著です。KVキャッシュの分散共有技術を駆使し、過去に計算されたKey-Value状態をハッシュ木構造でキャッシュ。2回目以降の問い合わせでは、長文テキスト全体のPrefill(事前計算)をスキップし、新規プロンプト差分のみを計算することで、GPUのコンピュート消費量を劇的に削減しました。
② Prefill / Decodeの完全物理分離(PD分離)
長大なプロンプトを処理するPrefill段階は「計算バウンド(Compute-bound)」であり、1トークンずつ順次出力するDecode段階は「メモリ帯域バウンド(Memory-bound)」という全く異なるハードウェア特性を持ちます。RDMAネットワークを介したPD分離アーキテクチャにより、クラスタ内のGPUをPrefill専用機とDecode専用機に物理的にクラスタリング。長文読み込みによって逐次応答のトークン生成がブロックされるジッター(遅延変動)を完全に排除しました。
③ 動的スパースアテンションとMoEの協調
長文全体のアテンション行列の中から、出力に寄与する重要度の高い領域のみを動的に選択するスパース(疎)アルゴリズムを導入。MoE(Mixture of Experts)構造と組み合わせることで、モデル全体のパラメータ規模を巨大に維持しながら、推論時に発火するアクティブパラメータを極小に抑え込みました。
4. 「検索ツール」から「自律思考型エージェント」への跳躍
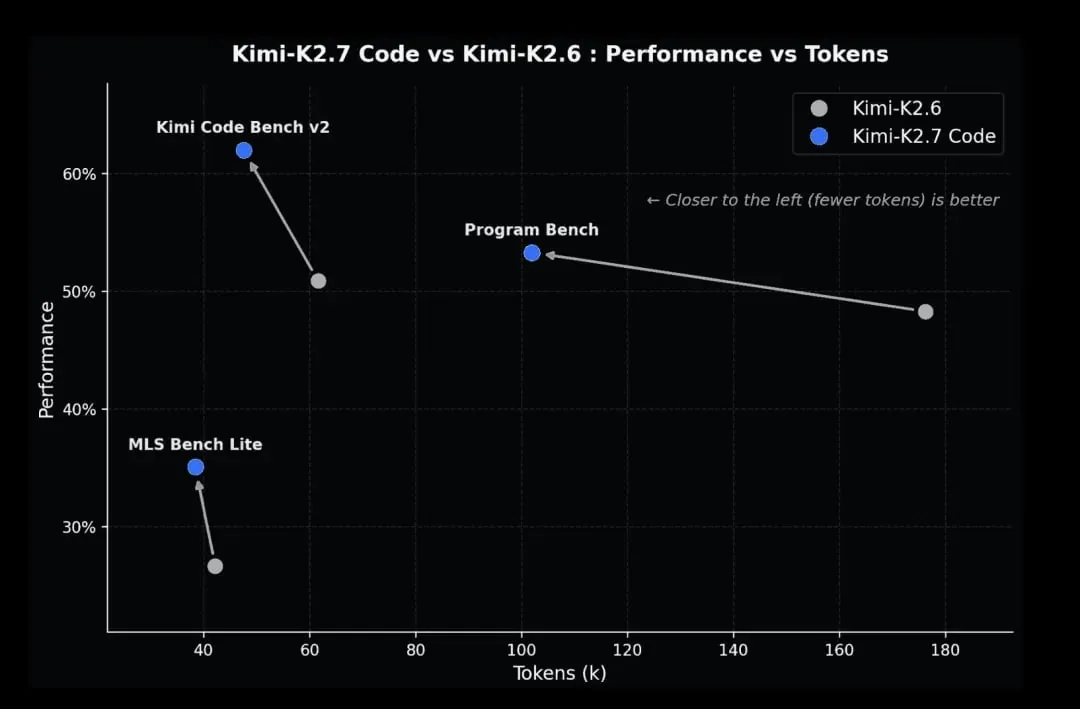
2026年に入り、Kimiの進化は「単なる超長文ドキュメントリーダー」の枠組みを急速に脱し始めています。最新の推論モデル基盤(K2.7 / K3系列)とエージェント機能の統合により、ユーザーの抽象的なリクエストを自律的に分解・検証・遂行するワークフローへとフェーズが移行しました。
サンドボックス内コード実行による「実数値検証」
自然言語モデルが最も苦手とする厳密な数値計算や統計処理に対し、Kimiは内部の安全なサンドボックス上でPythonスクリプトを自動生成・実行する機構を標準化しました。
例えば「過去10年間の特定セクター企業の売上成長率と設備投資比率の相関をプロットし、外れ値の要因を特定せよ」と命じた場合、Kimiはテキストから数値を抽出して計算を実行し、グラフを描画した上で、外れ値となった企業の決算脚注を特定して回答を作成します。ハルシネーション(幻覚)をコード実行という決定論的なフィルターで防ぐ設計です。
再帰的ディープリサーチ(Deep Search)
従来のWeb検索連携が「検索クエリを1回発行して上位リンクの要約を返す」だけだったのに対し、現在のKimiは専門リサーチャーの思考手順をエミュレートします。
- ユーザーの問いから仮説を構築
- 20〜30本以上の独立した検索クエリを並列発行
- 取得した情報間の矛盾(例:メディアごとの報道数値の違い)を検出
- 不足情報を埋めるための追加検索を反復
- 引用元リンクを精密に付与した長文レポートを構築
このアプローチは、元KimiリードのRichard Chien氏が提唱する人間とAIが対等に協働する自律ワークスペース「Raft」の思想とも共鳴しています。ツールとしてのAIではなく、自律的にタスクを完遂する「デジタルアナリスト」への進化です。
5. 日本企業の「RAG疲れ」を打破する実践的示唆
Kimiが成し遂げた「超長文ネイティブコンテキスト × 自律推論」の進化は、日本のエンタープライズIT、SI業界、そして業務DXを推進する企業に対して、痛烈かつ実践的な示唆を突きつけています。
現在、多くの日本企業が生成AI導入において「RAG疲れ」とも呼ぶべき深刻な停滞に直面しています。
断片化とパイプライン疲弊
- 機械的チャンク分割: 社内マニュアルや規約を断片化してベクトルDBへ格納
- 文脈喪失と回答崩壊: 類似度検索で断片のみを渡すため、表データ構造や章間文脈が失われ「使えない回答」が頻発
- 保守コストの肥大化: 埋め込みモデルの再調整やチャンクサイズ試行錯誤に工数を奪われ疲弊
全体俯瞰と推論モデルの融合
- 一式直接投入: 関連文書一式(数万〜数十万字)をそのままプロンプトのコンテキストへ装填
- 文脈脱落ゼロ: 階層型Prefix Cachingで推論コストを極小化しつつ、モデルが全容を俯瞰して論理思考
- パイプライン不要: 脆弱な外部RAG基盤の構築・保守工数を大幅削減し即戦力化
日本企業が学ぶべき教訓は、以下の3点に集約されます。
- 「断片化RAG」から「長文ネイティブコンテキスト」へのパラダイムシフト: 文書を細かく刻んで検索にかける複雑なパイプラインを構築・維持する前に、進化した長文LLMのコンテキスト窓をそのまま活用する設計を検討すべきです。特に法務、コンプライアンス、監査、製造業の設計仕様書のように「文脈全体の整合性」が生命線となる領域では、長文モデルへの直接投入が圧倒的な回答精度をもたらします。
- 推論コストを抑え込むインフラ設計の重要性: 長文AIの全社導入において最大の懸念となる従量課金コストは、社内基盤側でのPrefix CachingやPD分離といった分散キャッシュ技術の導入によって大幅に抑制可能です。「全社共通マニュアル」などの静的コンテキストをキャッシュ化することで、APIコストを90%以上削減する道筋が存在します。
- 「おしゃべりBot」から「成果物を納品するエージェント」への昇格: 単に社内ポータルにチャット窓を設置するDXの時代は終わりました。Kimiが示したように、コード実行による数値検証、自律的なWeb深層調査、複数文書のクロス比較など、「人間のホワイトカラーが行っている泥臭い知的タスクを最後まで完遂させる機能統合」こそが、真の業務効率化とROI(投資対効果)を生み出す鍵となります。
6. 結論:長文コンテキストが拓く自律型知的生産の地平
「長文コンテキスト」という一見シンプルな技術指標を極限まで突き詰め、ホワイトカラーの知的労働のあり方を根本から塗り替えたKimiの軌跡は、AI時代におけるプロダクト設計の力強さを雄弁に物語っています。
大手メガテックの資本力や価格破壊の圧力に晒されながらも、ユーザーの真の業務課題に第一性原理で向き合い、工学的ブレイクスルーを積み重ねることで築かれた独自の堀(Moat)。単なる「おしゃべりツール」の域を脱し、自律的に思考し成果物を納品するデジタルパートナーへの進化は、これからの業務AIのスタンダードを決定づけるものとなるでしょう。
「コンテキストの長さは、単なる仕様の数字ではない。それは人間の思考プロセスそのものの拡張であり、コンピュータと人間の最も自然なインターフェースである」—— 楊植麟(Moonshot AI 創業者・CEO)
コメント
...