1. 開発者が直面する「動画処理コスト」とMarlin-2Bの登場背景
これまでの商用クラウドAI(Gemini 2.5 FlashやGPT-4o等)による動画解析は、API従量課金コストが非常に高く、長時間の防犯カメラ映像や工場モニタリングを常時処理させるには非現実的でした。また、機密映像を外部クラウドに送れない製造業や医療現場からのセキュリティ懸念も根強く存在していました。
商用クラウドAPIの構造的限界
高額な従量課金コスト、ネットワーク往復レイテンシ、そして社内機密・工場現場映像を外部サーバーへ送信できないプライバシー規制がエッジ導入の壁となっていました。
- 24時間常時ストリーミング解析ではトークン費用が天文学的に膨張
- 通信遮断時のフェイルセーフが取れない
Marlin-2B エッジ特化の突破
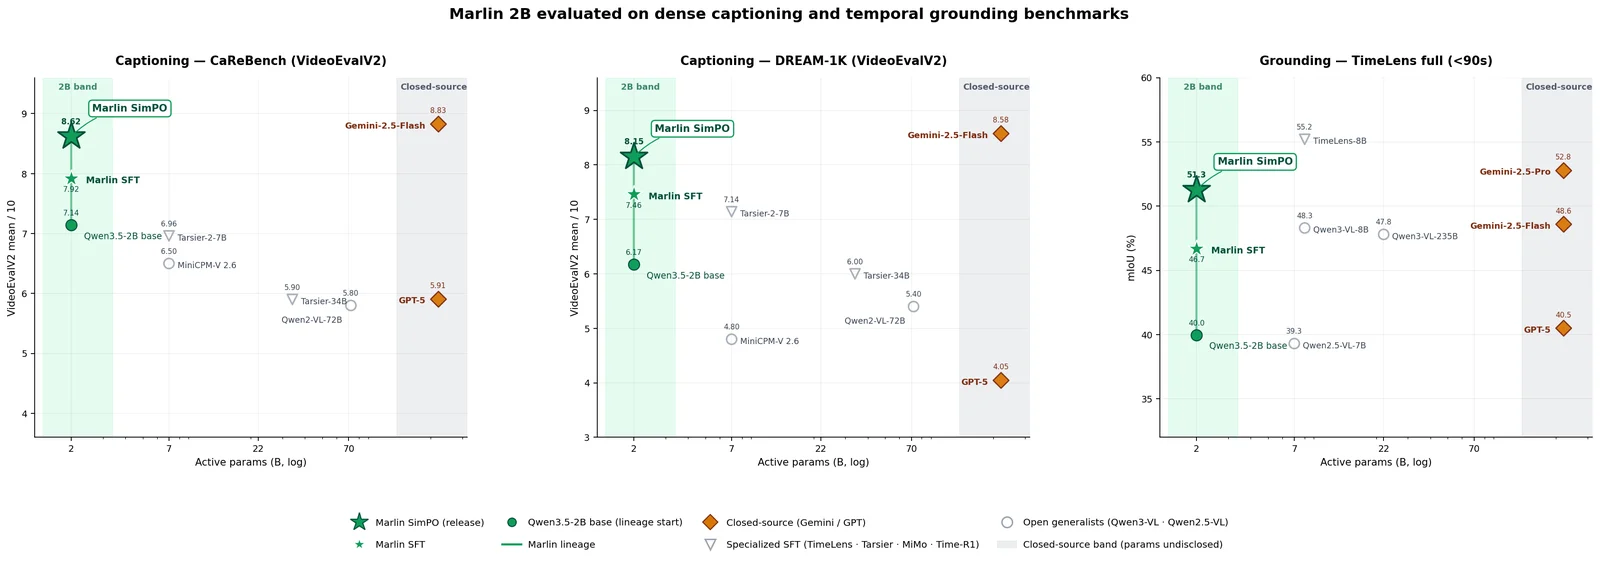
民生用GPU(RTX 4060等)やApple Silicon上で完全ローカル稼働。秒単位の時間軸特定(Temporal Grounding)に特化し、クラウド級の精度をゼロ通信コストで実現します。
- 7Bモデルを凌駕する時間特定精度(+6.4 mIoU)
- オンデバイス推論による完全なデータ主権とミリ秒応答
こうした課題に対し、技術コミュニティ(Hugging FaceやModelScope等)で「ローカル動作する動画AIのダークホース」として絶賛されているのが「Marlin-2B」です。汎用的なチャットボットを目指すのではなく、以下の2点に特化した「特化型モデル」設計が大きな支持を集めています。
- 何が起きているか(What): 映像内のイベントを高精度なキャプションとして構造化。
- いつ起きているか(When): イベントの開始・終了時刻を秒単位のタイムスタンプでピンポイント特定。
2. 開発者コミュニティでの口コミ・現場評価
オープンソースコミュニティや実践的な開発者の間では、Marlin-2Bに対して以下のようなリアルな評価が寄せられています。
👍 評価されているポイント(口コミと利点)
- 安価な民生用GPUで動作: RTX 4060(VRAM 8GB)クラスのグラフィックボードや、Apple Silicon(Mシリーズ)搭載Mac上でスムーズに動作。
- 直感的なPython API: Hugging Faceの
transformersおよびvLLMと完全互換。marlin.caption()で時間付きイベント記述、marlin.find()で「特定のシーン」を自然言語検索できるため、開発工数が大幅に削減される。 - 高精度な時間特定(Temporal Grounding): ベンチマーク(TimeLens-Bench)において、7Bクラスの競合モデル(Qwen2.5-VL-7B)を+6.4 mIoU上回る精度を記録。
# 開発者に高評価の直感的なAPI呼び出し例
from marlin import MarlinModel

model = MarlinModel.from_pretrained("NemoStation/Marlin-2B")
# 秒単位のタイムスタンプ付きキャプションを取得
captions = model.caption("input_video.mp4")
# 特定シーンの自然言語検索(00:01:23 - 00:01:28 を特定)
clip = model.find("作業員がヘルメットを着用した瞬間", video="input_video.mp4")
3. 実践運用で押さえるべき制約と回避策(ノウハウ)
開発者が本番プロダクトに組み込む際、コミュニティで共有されている「留意すべき3つのポイントと回避策」は以下の通りです。
| 技術的制約・特性 | 発生する課題 | エンジニアによる推奨回避策(Best Practice) |
|---|---|---|
| 240フレーム(約2分)制限 | 2 FPS固定のため、長尺動画を直接入力できない | 入力動画を事前に1〜2分単位に分割するChunkingパイプラインを前処理として構築する |
| 音声を直接処理しない | 映像フレームのみを解析し、会話ログを取得できない | Whisper等の軽量音声認識モデルと並列化し、マルチモデルパイプラインを組む |
| 特化型モデルによるハルシネーション | 複雑・曖昧な映像で稀に誤検知が発生する | 異常検知アラート等では閾値調整とログ検証スレッドを設ける |
4. 身体性AI(フィジカルAI)とマルチモーダルエージェントへの応用
現場のエンジニアが最も熱狂している応用領域が、人型ロボットや自動搬送車(AGV)、四足歩行ロボットへの搭載です。
当メディアが報じた星動紀元(RobotEra)STAR1の砂漠踏破やUnitreeの人型ロボット量産現場でも実証されている通り、身体性知能の現場では「ミリ秒単位のローカル知覚ループ」が不可欠となります。
カメラ映像ストリーム & Marlin-2B エッジ知覚(遅延 5ms)
オンデバイスNPU上で映像フレームを常時解析。障害物検出、作業対象物の特定、イベント変化のタイムスタンプをリアルタイム出力します。
音声入力 & Whisper ローカル解析(遅延 10ms)
作業現場での作業員指示や環境音をローカル音声認識モデルでテキスト化。外部通信を行わず完全閉域で処理します。
ローカルAgentコントローラーによる運動軌道生成
視覚知覚と音声指示を統合し、関節モーターやアクチュエータへミリ秒オーダーで制御指令(VLA: Vision-Language-Action)を伝達します。
大脳にあたる高次な言語思考やタスク計画はクラウド側の巨大モデルで行い、小脳にあたるリアルタイムな映像理解と反射的運動制御をMarlin-2Bのようなオンデバイスモデルに担わせる「ハイブリッド・ダブルブレイン構成」が、今後のロボティクスDXの標準となりつつあります。さらにHugging FaceのフィジカルAIオープンソース戦略とも共鳴し、エッジVLAの実装ハードルは劇的に低下しています。
「動画AIはもはやクラウドAPIの従量課金に怯えながら使うものではない。エッジの2Bモデルが、ロボットの目と耳をその場で動かす時代が来た」
5. まとめ:ローカル映像解析AIがもたらす新しいビジネス機会
Marlin-2Bの実用化は、「動画AI=高額なクラウドAPI」という常識を覆しました。日本の製造現場での安全モニタリング、防犯カメラのローカル自動アラート、動画編集ツールの自動タイムライン作成など、プライバシーとコストを両立した新しいエッジAIプロダクトが次々と生まれる基盤が整っています。
コメント
...