1. 直感の「System 1」から熟考の「System 2」へ:AI開発の力学転換
世界の人工知能研究は今、決定的なパラダイムシフトの渦中にあります。数兆トークンものウェブテキストを飲み込ませ、次の単語を確率的に予測する従来の「事前学習スケーリング則(Pre-training Scaling Laws)」は、Webデータの枯渇と膨大な学習コストの前に減速の兆候を見せ始めました。これに代わって主役に躍り出たのが、認知心理学者ダニエル・カーネマンが提唱した「遅い思考(System 2)」を人工ニューラルネットワークで再現する推論特化型モデル(Reasoning Models)の潮流です。
即答する直感(System 1)ではなく、出力を生成する前に内部で自問自答を繰り返し、複数の推論仮説を立て、誤りを自己修正しながら結論へと辿り着く「テスト時計算(Test-Time Compute)」の拡大。この領域で先陣を切ったのは米OpenAIの「o1」シリーズでした。しかし、OpenAIは推論の思考プロセス(Thinking Tokens)を完全にブラックボックスに閉じ込め、100万トークンあたり数十ドルという高額なプロプライエタリAPIの背後に囲い込みました。
これに対し、中国・アリババクラウド(Alibaba Cloud)のQwenチームが打ち出した一手こそが、完全オープンウェイト(Apache 2.0ライセンス)の推論モデル「QwQ-32B」です。
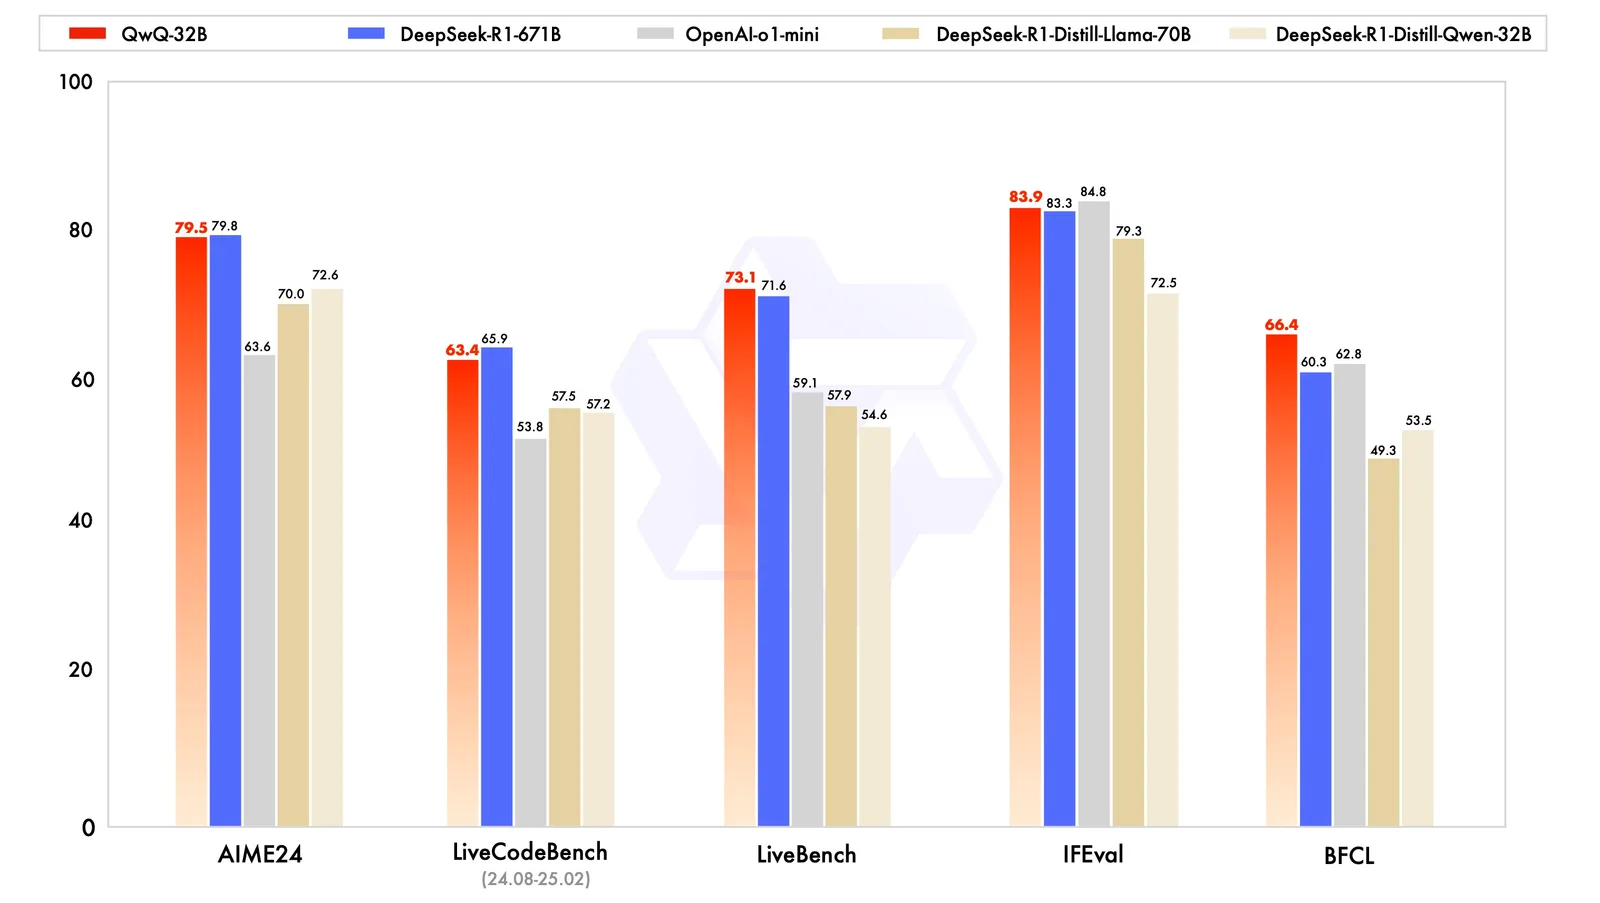
アリババが公開した「QwQ-32B(Qwen with Questions)」は、2024年末に公開されたプレビュー版での実験を経て、多段強化学習(Multi-Stage Reinforcement Learning)により大幅な進化を遂げた正式モデルです。特筆すべきは、OpenAI o1-miniを明確に凌駕し、6710億パラメータを誇るDeepSeek-R1のフルスケールモデルに迫る数学・コード推論性能を、わずか32B(320億パラメータ)の高密度(Dense)アーキテクチャで叩き出した点にあります。
これは単なるベンチマーク競争の更新ではありません。「思考するAI」を巨大データセンターのクラウドAPIから解放し、オンプレミスサーバーやエッジ環境へ民主化させる、オープンソース陣営による極めて戦略的な反撃の狼煙です。
2. 32Bが拓く「実用サイズ」の衝撃:671B巨艦とプロプライエタリへの挑戦
なぜ、アリババは70Bや数百億規模のMoE(Mixture of Experts)ではなく、「32B(320億パラメータ)」というサイズで勝負を仕掛けたのでしょうか。そこには、エンタープライズの現場とグローバル開発者が直面している「運用の現実」に対する研ぎ澄まされた洞察があります。
エンタープライズ導入における「32Bの黄金比」
7Bや14Bといった小型モデルは、軽量である反面、長大な数学的証明や数百行に及ぶコードの論理整合性を破綻なく維持する「認知容量(Capacity)」に限界を抱えがちです。一方で、DeepSeek-R1のような671B(活性化37B)の超大規模MoEモデルは、推論性能こそ極めて高いものの、数台の80GB H100/A100 GPUをインターコネクトで束ねる必要があり、中小企業や独立開発者、あるいは機密データを抱える製造業の現場にとって導入ハードルは依然として高位に留まります。
対して32Bモデルは、4ビットや8ビット量子化(AWQ / GGUF)を適用することで、単一のハイエンドGPU(NVIDIA RTX 4090 24GBやApple Silicon Mac Studio)、あるいはエンタープライズ標準のA100/H100単体ノードで快適にローカル実行可能です。
- OpenAI o1系列:完全クローズド / 思考過程不可視 / 高額API従量課金
- DeepSeek-R1 (671B):オープンウェイト / 超巨大クラスター必須(要マルチGPU)
- アリババ QwQ-32B:Apache 2.0 / 思考過程完全透過 / 単一ノードで即戦力運用
主要ベンチマークにおける実力検証
QwQ-32Bの実力は、難関数学競技や複雑なコーディング課題の標準ベンチマークにおいて極めて鮮明に現れています。
| 評価ベンチマーク指標 | QwQ-32B(アリババ) | OpenAI o1-mini | DeepSeek-R1(671B) | 評価領域と難易度の定義 |
|---|---|---|---|---|
| AIME 2024 | 79.5% | 63.6% | 79.8% | 米国数学招待試験(高度な多段階推論) |
| MATH-500 | 90.6% | 89.8% | 97.3% | 高校・大学レベルの多分野数学難問 |
| LiveCodeBench | 63.4% | 53.8% | 65.9% | リアルタイム・コンテスト級アルゴリズム実装 |
| GPQA Diamond | 65.2% | 60.0% | 71.5% | Google検索不可の大学院生レベル科学難問 |
| パラメータ規模 | 32B Dense | 非公開(推定小型) | 671B(活性化37B MoE) | 実配備時のハードウェア消費要件 |
| ライセンス形態 | Apache 2.0(商用可) | プロプライエタリ | MITライセンス | 企業独自改変・プライベート運用の自由度 |
数学オリンピック予選レベルの難度を誇る「AIME 2024」において、QwQ-32Bは79.5%を記録しました。これはOpenAIのo1-mini(63.6%)を大差で引き離し、20倍以上のパラメータ総数を持つDeepSeek-R1(79.8%)とコンマ数ポイント差の同水準に位置しています。
さらに、プログラミング能力を競う「LiveCodeBench」でも63.4%をマークし、従来の軽量コードモデルを圧倒。131,072トークン(131k)のフルコンテキスト長をサポートしているため、巨大なコードベースや学術論文の全章を思考空間に展開しながら、論理的なバグ特定や論証を遂行できます。
プロプライエタリ推論APIの企業リスク
- 思考プロセスのブラックボックス化:モデルがどのような前提で中間結論を下したのか監査できず、金融・医療・法務での説明責任(XAI)を果たせない。
- データ主権と情報漏洩の懸念:社内の核心的特許情報や製造ラインの不具合ログを米国のクラウドAPIへ送信し続けることへの法規・コンプライアンス摩擦。
- トークン課金の急膨張:System 2モデルは回答1件につき数千〜数万の思考トークンを消費するため、月額インフラコストが予測不能に跳ね上がる。
QwQ-32Bが提供するオープンな解決策
- 思考トークンの完全透過性:モデルの内部推論ログ(`<think>...</think>`)をすべて取得・解析可能。企業独自の論理監査フィルターを挿入できる。
- 完全閉域(オンプレミス)運用:社内GPUサーバーや国内データセンター内で完結稼働し、機密データを外部ネットワークへ1バイトも流出させない。
- 推論コストの劇的削減と固定化:Apache 2.0ライセンスにより、API従量課金から解放され、ハードウェアの稼働減価償却モデルで運用コストを固定化できる。
3. 多段強化学習(RL)と検証器が生み出した「内省と自己修正」の工学
パラメータ規模を32Bに抑えながら、なぜこれほど強靭な論理的耐久性を獲得できたのか。その技術的ブレイクスルーの核心は、決定論的検証器(Deterministic Verifiers)を組み込んだ多段強化学習(Multi-Stage RL)にあります。
従来の強化学習(RLHF)は、人間の評価者を模倣する「報酬モデル(Reward Model)」に依存していました。しかし、報酬モデル自体がニューラルネットワークであるため、「賢そうに見えるが論理的に間違っている回答」を高評価してしまう「報酬ハッキング(Reward Hacking)」に脆弱でした。
アリババのQwenチームは、この構造的課題を乗り越えるために2段階の体系的な強化学習フレームワークを構築しました。
客観的正誤判定によるドメイン特化RL(数学・コード)
曖昧な報酬モデルを排除し、数学問題には厳密な「正解値検証器(Accuracy Verifier)」、コード生成にはサンドボックス上で単体テストを自動実行する「コード実行サーバー(Code Execution Server)」を報酬シグナルとして接続。モデルは何万回もの試行錯誤を通じて、偽陽性のない客観的フィードバックから「自己反省(Self-Reflection)と解法の探索」を自律学習しました。
汎化アライメントと「ツール利用型エージェント」の融合
数学やコードで獲得した思考力を、日常的な指示追従や人間選好へ汎化。さらに決定的な差別化として、外部ツール呼び出し(Tool-Use)と推論思考ループの統合を実現しました。モデルは思考の途中でPythonインタープリタや検索ツールを呼び出し、その実行結果を観察(Observation)して推論を修正するエージェント能力を獲得しています。
「ツールを使える推論モデル」という新たなフロンティア
多くの推論モデルは、純粋なテキスト生成の中で思考を完結させようとするため、高度な数値計算や最新の事実確認において幻覚(ハルシネーション)を起こすリスクを孕んでいます。
しかしQwQ-32Bは、「思考 ➡️ ツール実行 ➡️ 結果の検証 ➡️ 思考の修正 ➡️ 最終回答」という動的なフィードバックループを内包しています。たとえば、複雑な物理シミュレーションの計算を行う際、自らの頭の中だけで数値を追うのではなく、即座にPythonスクリプトを書いてバックグラウンドで実行し、エラーが出ればそのスタックトレースを読み取ってスクリプトを書き直すという、人間のシニアエンジニアさながらの行動様式を見せます。
この「Agentic Reasoning」の統合こそが、先行するプレビュー版(QwQ-32B-Preview)で見られた堂々巡りの思考ループや多言語混ざり(Language Mixing)を劇的に抑制し、実ビジネスで即座に使える安定性を生み出しました。
4. クラウドと開発者の二重包囲網:アリババの商業エコシステム戦略
なぜアリババは、自社が多大な計算リソースと研究費を投じて開発した最前線の推論モデルを、商用利用無制限のApache 2.0ライセンスで無償配布するのでしょうか。この一見すると利他的に見える戦略の背景には、中国最強のクラウドベンダーとしての冷徹なプラットフォーム戦略(Linux of AI戦略)が存在します。
先述したコード特化モデル「Qwen2.5-Coderが開発環境を塗り替えた現実」でも触れた通り、アリババクラウドの基本戦略は「モデルのオープン化でグローバル開発者の心理的デファクトスタンダードを奪取し、本番運用のAPIおよびインフラ計算資源で巨額の収益を回収する」という二重構造に基づいています。
1. 「思考トークン課金」を巡る価格破壊とクラウドシフト
推論モデルは、ユーザーが入力したプロンプトに対して数十〜数百トークンで返答する従来のチャットボットと異なり、1回のクエリで数千から数万トークンもの「思考プロセス」を生成します。これはクラウドベンダーにとって、従来の数十倍のトークン消費量(=計算需要)を生み出す巨大な鉱山です。
OpenAIやAnthropicが思考トークンを高価格帯で維持する中、アリババは自社の開発プラットフォーム「阿里百錬(Bailian / Model Studio)」において、QwQ-32BのフルマネージドAPIを100万トークンあたり数セントという破格の単価で提供しています。
「オープンソースだから自前のGPUで検証を始められる。しかし、数百万人のユーザーにスケールした瞬間、自社クラスターを維持するよりアリババクラウドのサーバーレスAPIを叩いた方が圧倒的に安く、信頼性が高い」——この経済合理性の引力によって、世界中のAIスタートアップやエンタープライズのワークロードがアリババのインフラへと吸い寄せられていきます。
2. 蒸留(Distillation)の起点としてのエコシステム覇権
推論モデルの進化において、先行する巨大モデルの思考ログから知識を抽出し、より小型の7Bや3Bモデルへ圧縮する「蒸留技術」は不可欠な潮流となっています(詳細は過去記事「Qwenをベースにする思考モデルの蒸留技術と今後の展望」参照)。
QwQ-32BがApache 2.0で解放されたことで、世界中の研究機関や企業は、OpenAIの規約違反(競合モデルの学習にAPI出力を使用する禁止条項)を恐れることなく、合法的に高品質な思考データを自社モデルへ蒸留できるようになりました。世界中で派生する無数のカスタム推論モデルがQwenのトークナイザーと重みを基盤とする世界が完成すれば、基盤モデルの標準プロトコルとしての「Qwen経済圏」は揺るぎないものになります。
5. 機密データと推論AI:製造現場におけるプライベート運用の現実解
アリババQwQ-32Bの登場は、日本国内の産業界、とりわけ製造業、金融機関、医療・精密機器分野に対して極めて現実的かつ実践的な選択肢を提示しています。
これまで日本の多くのエンタープライズは、米国のクラウドAPIを利用する際の「データ海外移送規制(データ主権)」や「知財流出リスク」に直面し、本格的な生成AIの業務コアへの組み込みに二の足を踏んできました。キーエンス、ファナック、ソニー、トヨタといった世界屈指の精度と安全性を求める日本のモノづくり企業にとって、幻覚(ハルシネーション)を伴い、監査不可能なブラックボックスAIは製造ラインや設計部門に安易に投入できるものではなかったからです。
しかし、QwQ-32Bが示した「32Bの高密度サイズ・完全透過な思考プロセス・商用フリー」のパッケージは、以下の具体的なブレイクスルーを日本企業にもたらします。
- さくらインターネットや社内プライベートクラウドでの完全自社運用
高額なマルチノードH100クラスタを組むことなく、国内データセンターの単一GPUサーバー群や社内オンプレミス環境で、o1級の論理推論エンジンをセキュアに常駐させることが可能です。 - 設計図面チェックと品質保証(QA)の論理的検証
複雑な部品表(BOM)の突き合わせ、プログラマブルロジックコントローラ(PLC)のラダーロジック解析、法規適合チェックなど、これまで熟練エンジニアの目視に頼っていた「根拠の明示が必要な業務」において、思考プロセスをログとして完全に監査しながら自動化を進められます。 - 自社独自ドメインへの強化学習(RL)の適用
企業独自の正誤判定器(社内テストスイートやCAD/CAE解析エンジン)を接続し、自社の製造ルールに完全に合致するカスタム推論モデルを自前で追加学習させる道が開かれました。
おしゃべりな会話AI(System 1)の熱狂が一段落し、実社会の重厚な課題を解決する「思考するAI(System 2)」の実用期へ突入した今、QwQ-32Bが切り開いたオープン推論モデルの道筋は、世界のテック勢力図を根底から書き換えつつあります。
参考資料・情報元
- [Qwen Team 公式技術ブログ] QwQ-32B: Embracing the Power of Reinforcement Learning (2025-03)
- [Hugging Face / ModelScope] Qwen/QwQ-32B Model Repository & Technical Specifications (2025-03)
- [Alibaba Cloud Intelligence / arXiv:2412.15115] Qwen2.5 Technical Report: Foundation and Alignment (2024-12)
- [Alibaba Cloud Official IR & Tech Newsroom] Alibaba Cloud Generative AI & Model Studio Strategy (2025-03)
- [極客公園(GeekPark)/ 36Kr 産業特写] 中国オープンソースAIの新たなマイルストーン:QwQの工学的意義 (2025-03)
コメント
...