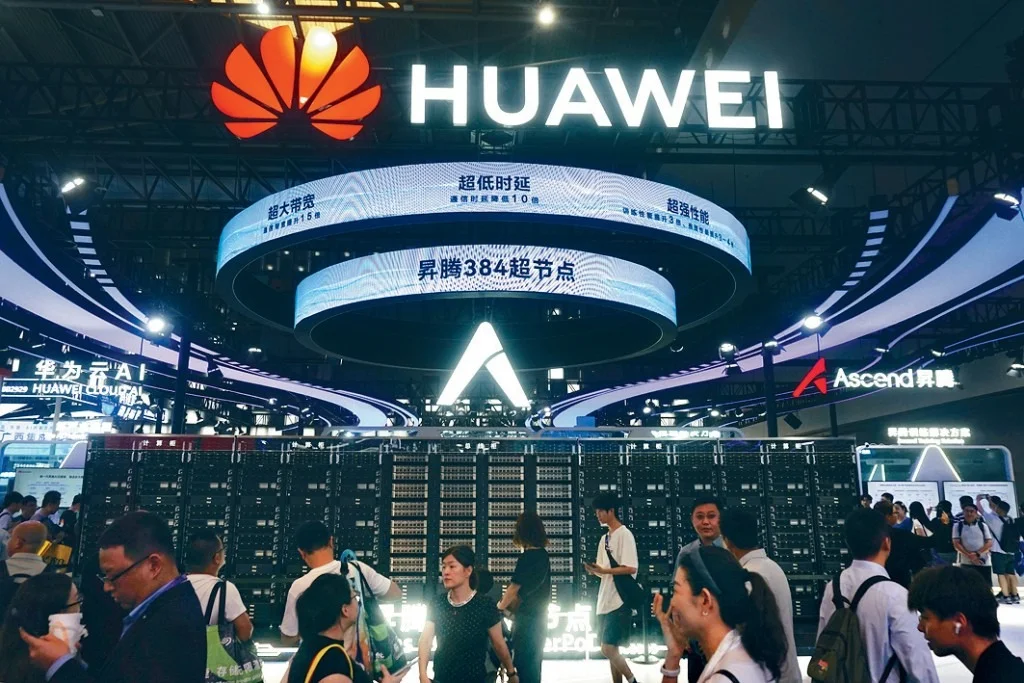
上海で開催された「世界人工知能大会(WAIC 2026)」において、AIモデルやロボットと並び大きな注目を浴びたのが、AIのインフラを支える計算資源(計算リソース)の技術進化です。
その頂点として最優秀プロダクト賞「鎮館之宝」を受賞したのが、ファーウェイ(華為技術)が発表した最新のAI超大規模ノード「Atlas 950 SuperPod(超ノード)」です。米国のハイエンドAIアクセラレータ輸出規制が長期化する中、単一チップの性能競争から「ネットワークとシステム全体の最適化」へと舵を切った中国の最新ハードウェアスタックの到達点を示しています。
1. 1,024枚の昇騰(Ascend)チップが直結する「1 EFLOPS」の世界
Atlas 950超ノードの最大の技術的特徴は、独自開発の昇騰(Ascend)AIプロセッサ1,024枚を超高速バス・光学インターコネクトで直接連結したシステム統合設計にあります。
単一のキャビネット群(システムノード)で、FP16/INT8推論・学習の総合演算性能は1 EFLOPS(100京回/秒)という驚異的な大台に達しました。従来のサーバーをLANや一般的なInfiniBandで接続するクラスターとは異なり、1,024枚のアクセラレータが「あたかも1枚の超巨大なAIグラフィックスカード」としてメモリ空間を共有して動作します。
これにより、兆パラメータ規模(Trillion-parameter)の超巨大言語モデルの事前学習や、超高並行での推論リクエストを、分散通信のボトルネックなしに高速処理できます。
2. 50万枚の接続を可能にする「SuperCluster」構築ブロック
ファーウェイはWAIC 2026において、このAtlas 950超ノードを最小構成単位(ビルディングブロック)として積み上げ、最大50万枚のAIカードを連結・制御する「SuperCluster(AI超巨大クラスター)」の構築構想を発表しました。
NVIDIAのNVLinkやGB200 NVL72に匹敵・対抗するこの大スケール接続技術は、通信プロトコルの独自最適化と風冷・液冷混合冷却技術によって支えられています。キャビネット内の高密度実装による発熱問題を克服し、24時間365日の連続高負荷学習に耐える可用性を確保しました。
3. 「単体チップ」から「システム工学」への戦略的転換
米国の輸出規制により、最先端の微細化プロセス(3nm/4nmなど)による単体半導体の性能向上には制約が存在します。しかし、ファーウェイをはじめとする中国のAIインフラベンダーは、「設計革新とシステムレベルの集積化(System-level Engineering)」によってこの壁を突破しようとしています。
製造プロセスの制約を、基板設計、光インターコネクト、トポロジー構造、そして独自のAIコンパイラ(MindSpore)の最適化によってカバーし、実効性能でグローバルなトップレベルに迫るアプローチです。会場では、金融機関の不正検知、エネルギーグリッドのシミュレーション、スマートシティの動画解析など、すでに11の主要産業でAtlasシステムが実稼働している事例が提示されました。
4. 編集部解説:日本のAIインフラとクラウド基盤への示唆
世界のAI開発が「より巨大なコンピューティングパワーの構築」へと突き進む中、エネルギー効率と高密度実装、そしてクラスター全体の通信効率化はすべての国にとって共通の課題です。
ファーウェイがAtlas 950で示したアプローチは、単にチップを購入してラックに並べる従来のデータセンター構築法を超え、ハードウェアとソフトウェアが極限まで垂直統合された「巨大AI計算マシン」の未来像です。少子高齢化やDX推進に伴い国内データセンターの需要が急増する日本にとっても、ハードウェアのシステム集積技術と冷却・電力最適化の最前線として注視すべきテクノロジーの到達点と言えます。
なお、同領域における最新の産業構造と競争力学については、本誌が検証したVRAM不足を力業で解くな:CXL3.1メモリプールの現実およびCPUを完全バイパス:NVMe-oFとGDS、推論インフラの現実の分析もあわせて参照されたい。
コメント
...