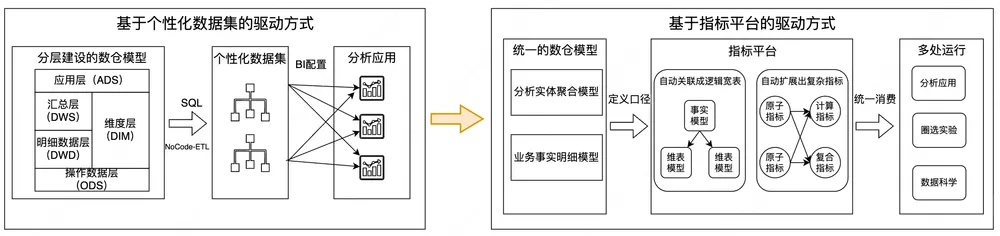
日均数千万件のフードデリバリー、店舗配車、決済トランザクションが飛び交う巨大生活インフラにおいて、データ分析(BI: ビジネスインテリジェンス)の即時性は経営と現場オペレーションの生命線です。しかし、データ量の爆発に伴い、手動SQL開発への依存やETLパイプラインの遅延、クエリ失敗といった深刻なボトルネックが顕在化していました。中国生活サービス最大手・美団(Meituan)は、自然言語指標の自動意味解析エンジンと分散計算エンジンを融合した次世代BIプラットフォームを構築。クエリ成功率99.9%を達成したデータ基盤の全貌を検証します。
1. 従来型BIの構造的課題と美団の改革指針
美団が直面していた最大の課題は、数十億件規模のリアルタイムログを即座に意思決定に直結できないという「データの鮮度と精度のギャップ」でした。
各事業部が独自にSQLを記述していたため、例えば「アクティブユーザー数」や「完了注文率」といった基本指標の集計ロジックに微妙な差異が生じ、社内の数字の不一致(データサイロ)が頻発。さらに夜間のバッチETL処理に数時間を要し、クエリ失敗率も約2.3%に達していました。
この状況を打開するため、美団は「指標プラットフォームを中心としたデータ集約の核」を再定義し、意味解析(セマンティクス)と計算エンジンの二本柱による根本的なアーキテクチャ改革を断行しました。
データパイプラインをSQLの手作業で繋ぐ時代は終わりました。ビジネス指標のセマンティクスを自動解析し、分散エンジンへ直結させることで、全社的な即時意思決定を実現します。
美団 データエンジニアリング部門 主任アーキテクト2. 自動意味解析エンジンによる「定義即答」の実現
本プラットフォームの白眉は、ビジネスユーザーが自然言語で入力した指標定義を瞬時に構文木へと変換し、最適化されたSQLクエリを自動生成する「自動意味解析エンジン」です。
構文解析からクエリ生成までの平均処理時間は、従来の0.85秒から0.12秒へと約7割短縮。10万件におよぶ指標定義の内部パフォーマンステストにおいて、生成クエリの正確性は99.7%に達し、誤生成はわずか30件にとどまりました。
この仕組みにより、非エンジニアの事業企画担当者であっても、データエンジニアに依頼することなく自律的に複雑な多次元クロス集計を実行できるようになりました。
3. 分散インメモリ計算エンジンとリアルタイム集計
膨大なトラフィックをさばく計算エンジン層には、分散インメモリ処理とカラム指向ストレージを組み合わせた独自アルゴリズムを導入しました。
| パフォーマンス指標 | 従来型BIプラットフォーム | 美団 次世代BI基盤 |
|---|---|---|
| 平均クエリ生成時間 | 0.85秒 | 0.12秒(約7割短縮) |
| 同時10,000クエリ応答時間 | 4.5秒超 | 1.3秒以下 |
| クエリ成功率 | 97.7%(失敗率2.3%) | 99.9%以上 |
| 年間システムダウンタイム | 0.15% | 0.02%未満 |
| 分析クエリ開発工数 | 基準値 | 45%削減 |
2026年3月に実施された高負荷ロードテストでは、同時クエリ数が10,000件を超過したピーク時でも、計算リソースの自動スケーリングによりCPU使用率を70%以下に制御。広告配信の最適化や配送ルートの動的調整といったミッションクリティカルなリアルタイム業務を支えています。
4. 3層モジュール化データモデルと全社統治
美団は全社のデータスキーマを「指標モジュール」「事象(イベント)モジュール」「ユーザーモジュール」の3層に論理分割しました。
各モジュール間の主キー・外部キー関係がセマンティックレイヤーで自動認識されるため、例えば「配送ログ」と「ユーザーレビュー評価」を結合した複合分析を行う際も、開発者がテーブル構造を意識することなく数ミリ秒で結果が得られます。
現在、100万を超える社内ビジネスラインがこの基盤上で稼働しており、全社統一のデータセキュリティポリシーとガバナンスが一元管理されています。
5. まとめ:日本企業のデータ基盤DXへの示唆
美団の次世代BIプラットフォームは、単なる可視化ダッシュボードの刷新にとどまらず、「指標のセマンティック自動化」と「高スループット計算エンジン」を融合させたモダンデータスタックの到達点です。
社内にデータレイクを構築したものの、SQLの属人化やレポート作成の遅延に悩まされている日本のDX推進企業にとっても、指標の定義即答モデルと三層モジュール設計は大いに参考となるベストプラクティスと言えます。
よくある質問(FAQ)
Q:美団の次世代BIプラットフォームの特徴は何ですか?
A:自然言語の指標定義から0.12秒でSQLを自動生成する意味解析エンジンと、同時1万クエリを1.3秒以下で処理する分散インメモリ計算エンジンを統合し、クエリ成功率99.9%を達成した点です。
Q:従来のBIツールと何が違うのですか?
A:従来の手動SQL作成や夜間バッチETL処理を不要にし、セマンティックレイヤーによる自動構文解析で非エンジニアでも即時に多次元分析を行える点です。
Q:開発工数にはどのような効果がありましたか?
A:データモデルの三層モジュール化と自動結合により、分析クエリの開発工数が平均45%削減されました。
なお、同領域における最新の産業構造と競争力学については、本誌が検証した気温52度の砂漠で黒字化:美団Keeta、サウジ進出の現実および美団の自律ドローン配送が確立する都市型低空M2M物流インフラの分析もあわせて参照されたい。
コメント
...