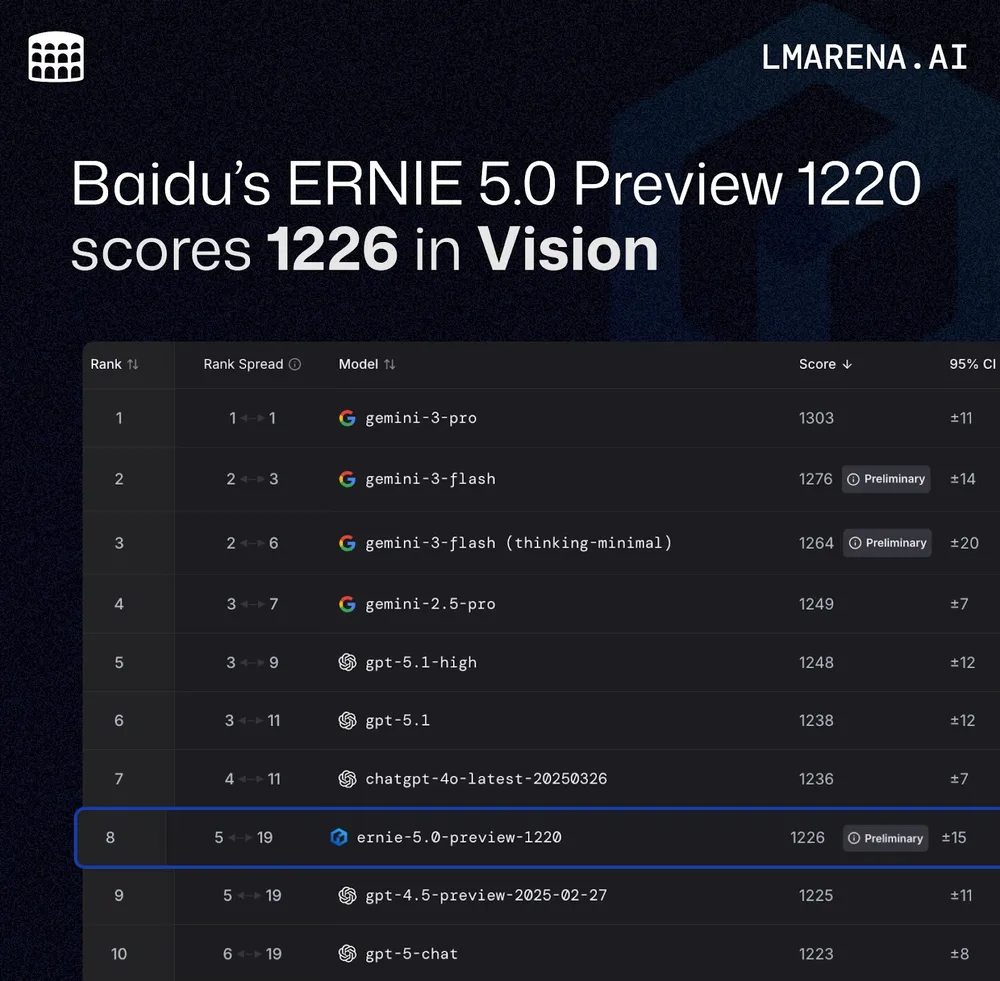
1. 視覚理解の新地平:中国モデル初のVision Arena世界トップ10入り
大規模言語モデル(LLM)のテキスト性能競争に続き、画像とテキストを同時に高精度で理解・生成する「マルチモーダルAI」が次世代の産業競争の焦点となっています。
Baidu(百度)が開発したマルチモーダル大規模モデルのプレビュー版「ERNIE-5.0-Preview-1220」が、国際的な評価ベンチマーク「LMArena Vision Arena」において1,226点を獲得。中国国内のモデルとして首位、世界全体でも第8位にランクインする快挙を達成しました。
- 文字と画像の断絶:物体検出(OCRやラベル付け)にとどまり、画像内の文脈や因果関係を言語化できない制約。
- 幻覚(ハルシネーション):画像の細部とテキスト生成の整合性が崩れ、存在しない物体を記述する傾向。
- 解像度制限:縮小された画像データからでは微小なテクスチャや図表の数値を正確に読み取れない問題。
- 混合注意機構(Mixed-Attention):画像内の特定領域とテキストトークンを動的に直接マッピング。
- 詳細記述の忠実度0.92:細微なニュアンスやユーモア、比喩表現を含むハイコンテキストな画像推論を実現。
- 大規模視覚語彙拡張:多言語OCRと専門図面・グラフの解釈を同一モデル内で高精度処理。
2. LMArena Vision Arenaの評価基準と実戦性能
Vision Arenaは、AIモデルが「画像とテキスト」をいかに深く同時に理解できるかを測定する国際的なブラインドテスト評価システムです。
画像内に含まれる物体や文字の認識精度だけでなく、文脈の論理的一貫性、ビジュアルデータの高度な推論(画像内の複雑な関係性やユーモアの解釈など)を人間の評価者が直接判定します。そのため、商用アプリやモデル選定を行う開発者からもっとも信頼性の高いベンチマークと位置付けられています。
「画像に何が写っているかだけでなく、なぜそれが起きているのかを語れるか。Vision Arenaでの8位獲得は、中国モデルが真の視覚的思考力を獲得したことを証明しています」マルチモーダル評価エンジニア
1,200以上のモデル評価データが蓄積される中、ERNIE-5.0-Preview-1220は前世代の中国製モデル最高記録(1,112点)を100点以上更新する1,226点をマーク。特に画像に対する自然な説明文生成(キャプション生成)や、画像に基づいた複雑な質疑応答(VQA)において抜群の安定性を発揮しました。
3. 独自アーキテクチャ「混合注意機構(Mixed-Attention)」
技術構造において特筆すべきは、最新のVision Transformer(ViT-G)ベースの画像エンコーダと、高度に最適化されたTransformerデコーダを結合した点にあります。
従来のモデルでは、画像の特徴量を単純にフラットな埋め込みベクトルに変換してLLMに渡していたため、空間的な位置関係や階層構造が失われがちでした。
ERNIE 5.0では、Baidu独自の「混合注意機構(Mixed-Attention)」を搭載。テキストの文脈情報と画像の幾何学的特徴を双方向に参照させ、画像内の特定領域がプロンプト内のどの語句と連動しているかをリアルタイムに整列(アライメント)させます。これにより、図表の数値読み取りや専門的な外観検査におけるエラー率を大幅に低減させました。
4. 産業応用シナリオと主要プレイヤーへの影響
視覚理解モデルの進化は、実ビジネスの現場に直ちに直結します。
| プレイヤー | 想定される影響とビジネス機会 |
|---|---|
| Baidu (百度) | 国際的な技術的実証を獲得したことで、グローバルクラウド市場におけるエンタープライズ商用契約を促進。 |
| AIスタートアップ | 高度なビジョンAPIを活用し、図面解析や医療画像スクリーニング、スマート小売アプリを短期間で構築可能。 |
| 日本のAIベンダー | 漢字・日本語・英語が混在する看板や帳票の高精度認識モジュールとして、製造業・流通業での活用余地が拡大。 |
5. 日本企業への示唆:物理空間とAIの融合に向けて
日本国内のAIソリューションは依然としてテキストチャット中心のものが多く、画像認識と自然言語の統合的活用は道半ばにあります。
しかし、ERNIE 5.0のような高精度な視覚理解モデルがAPIとして利用可能になることで、工場の自動検品ライン、医療現場における画像診断補助、自律走行ロボットの障害物セマンティクス理解など、物理空間と連携するサービス開発のハードルが劇的に低下します。
日本企業にとっても、早期にマルチモーダル基盤モデルを社内ワークフローや自社製品へ組み込み、特定産業ドメインに最適化した応用システムを構築することが、今後のDX競争における重要な差別化要因となります。
よくある質問(FAQ)
Q1: 画像に含まれる日本語や英語の手書き文字の認識精度はどのくらいですか?
A1: 大規模視覚語彙拡張技術により、画像内のテキスト認識(OCR)と文脈の解釈を同時に行うことができ、多言語が混在した領収書や看板、手書き文書のデータ化において極めて高い精度を発揮します。
Q2: 実装のためのAPIキーはどのように取得できますか?
A2: 百度智能云(Baidu AI Cloud)のデベロッパーポータルから申請することで、テスト利用向けのAPIキーとサンプルコードが即時提供されます。
Q3: 今後、動画認識への拡張は行われますか?
A3: ERNIE 5.0シリーズでは、本バージョンに続き、映像の時系列理解や音声と同期したマルチモーダル処理能力を強化したプレビューモデルがロードマップに沿って順次公開されています。
なお、同領域における最新の産業構造と競争力学については、本誌が検証した「オープンは高すぎる」李彦宏、百度AIエージェントの現実およびMeta買収を中国規制に阻まれたManusが独立再起動への分析もあわせて参照されたい。
コメント
...