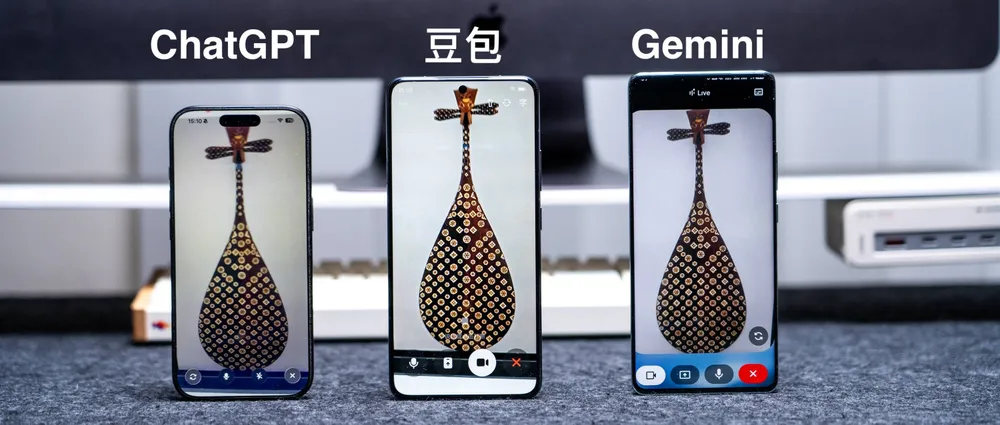
1. 現場の展示物を前に試されるマルチモーダルVLMの真価
近年、美術館や博物館の鑑賞ガイドとして生成AIを活用する動きが世界的に加速しています。中国ではByteDance(バイトダンス)が開発した大人気AIアシスタント「Doubao(中国名:豆包 / ドウバオ)」が、実際の美術館で「AI解説員」として導入され、音声や映像を通じたガイドを提供して大きな話題を呼んでいます。
中国の人気テックメディア『APPSO』が上海浦東美術館にて実施した同一条件テストでは、Doubao(ByteDance製「Seed-1.8 VLM」搭載)、ChatGPT(OpenAI製)、Gemini(Google製)の3大モデルを同一の歴史的文物や名画の前に配置し、画像理解と推論精度の比較が行われました。
Doubao(Seed-1.8 VLM搭載)
- 微小ディテールの検出: 唐代の銀製水差しに描かれた馬の微小ポーズや陶俑の衣装特徴を画像から正確抽出。
- 文脈・歴史背景の自律結合: レンブラント『夜警』の光と影から、実際は昼間の行軍である誤解を自発的に解説。
- 鑑定ロールプレイ: 明代の陶磁器レプリカの不自然なツヤや絵付けのズレを認識し、即座に偽物と判定。
ChatGPT & Gemini
- 視覚解像の甘さ: ChatGPTはテキスト知識が豊富だが、写真の細部特徴を拾えず一般的な解説に終始。
- 複数物体の空間誤認識: Geminiは古代飲料具セットの境界を分離できず、全体を単一物体として誤認。
- 過度なガードレール: 真贋判定タスクに対し「専門家に相談してください」と回答制限が強く発動。
「単に番号を押して録音音声を聴く時代から、スマホをかざして疑問を対話する時代へ——VLMの視覚推論力こそが文化財と来館者を結ぶ新たな架け橋となる」
APPSO Cultural Tech Editorial2. 比較実験:3大AIモデルによる「解説員」実力テスト
テストでは、ランダムに選ばれた歴史的文物や名画をスマートフォンのカメラで写し、各AIに対して「この作品の特徴は何か」「歴史的背景は?」といった基本的な質問から、細部の特徴を捉える「視覚推論」、さらには偽物の美術品を見分ける「鑑定」といった高度なタスクまで要求されました。
① Doubao(ドウバオ):画像詳細の認識と文脈理解で圧倒
Doubaoは最新の「Seed-1.8 VLM」を搭載しており、ビジュアルの認識精度で他を圧倒しました。唐代の銀製水差しに描かれた馬の細かなポーズや、北魏の陶俑の服装デザインについて、画像から直接特徴を拾い上げ、歴史的背景と結びつけた正確な解説を行いました。
② ChatGPT:丁寧な記述だが視覚ディテールは弱め
ChatGPTは美術史や歴史背景に関する知識量が豊富で、テキストの構造化や詳細な背景説明には長けています。しかし、提供された写真の細部に対する推論能力はDoubaoに一歩譲り、一般的な解説を長く出力する傾向が見られました。
③ Gemini:マルチモーダル連携に一部課題
GoogleのGeminiは、Googleレンズなどの強力な検索技術と統合されているものの、年代の誤認や、複数の展示品が1つの写真に写っているケースにおいて、各物体の境界を正しく認識できず、全体を一つの物体として誤認する場面がありました。
3. 日本の美術館・博物館における導入のメリット
日本国内でもAIを活用したガイドの試験導入が始まっています。例えば、東京国立近代美術館ではChatGPTのAPIをベースにした対話型案内ボットの実験が行われました。今回のテスト結果から、視覚言語モデル(VLM)を搭載したAIガイドを導入することには以下の大きなメリットがあると考えられます。
- スマートフォン撮影からの即時解説
展示品を自分のスマホで撮影するだけで、音声や対話形式で個別の解説が受けられます。従来のオーディオガイドのような「特定の番号を入力する」手間が省け、能動的な鑑賞体験を提供します。 - 多言語対応の自動化
インバウンド(訪日外国人観光客)の増加に伴い、展示パネルの翻訳コストが課題となっていますが、AIであれば撮影された展示物を英語、中国語、韓国語など、来館者の母国語にリアルタイムでローカライズして解説可能です。 - 対話による「気づき」の獲得
「この絵の右下にいる人は誰?」「なぜこの色を使ったの?」といった、個別の細かい疑問に対してもAIが対話形式で即座に答えてくれるため、学習効果や満足度を高めることができます。
4. 実用化に向けた今後の課題と注意点
一方で、日本の文化施設やテック企業がこの技術を本格導入する上では、いくつかの課題をクリアする必要があります。
- ハルシネーション(AIの嘘)対策
歴史的事実や美術的解釈において、AIが誤った事実をもっともらしく出力するリスク(ハルシネーション)は依然として存在します。公式ガイドとして運用する場合、信頼できる内部データベース(RAG技術などの適用)のみを参照させる厳格なデータ制限が必要です。 - 著作権と商用利用の権利管理
現代アートなど著作権が存続している作品については、写真撮影やAIによる画像解析・テキスト生成が著作権侵害にあたらないか、法的な整理とアーティストとの合意形成が必須です。 - 安全性と解説の深みのバランス
ChatGPTやGeminiが見せた「過度なガードレール」は、公式ツールとしての安全性を保証する一方で、ユーザーの好奇心を削いでしまう恐れがあります。美術館に特化したローカルな知識ベースを学習させ、安全かつ豊かな表現力を発揮させるチューニング(微調整)が求められます。
5. まとめ:文化施設DXを加速させるエッジVLMの可能性
マルチモーダルVLMを搭載したAIは、画像と文字を統合して理解することで、これまでにないリッチな体験を提供する「AI解説員」としての地位を確立しつつあります。
日本においても、地方の小規模な博物館やギャラリーなど、ガイドの雇用や多言語対応が難しい現場において、この低コストかつ高性能なAIテクノロジーは大きな救世主となるでしょう。
なお、同領域における最新の産業構造と競争力学については、本誌が検証した「80点の3Dはゴミだ」Tripo、秒速生成の狂熱と冷酷な現実および「青いリンクは死んだ」元百度・景鯤、AI検索で1500億円企業への分析もあわせて参照されたい。
コメント
...